Scalabilità: lo stato dell’arte nell’IA
Una breve pausa intergenerazionale
Mi sembra il momento giusto per fare il punto su dove siamo con l’IA e su cosa potrebbe riservarci il futuro. Voglio concentrarmi esclusivamente sulle capacità dei modelli di IA, e nello specifico sui modelli linguistici di grandi dimensioni che alimentano chatbot come ChatGPT e Gemini. Questi modelli diventano sempre più “intelligenti” col passare del tempo, e mi sembra utile riflettere sul perché, poiché ciò ci aiuterà a capire cosa ci aspetta. Per farlo, occorre analizzare più a fondo come vengono addestrati i modelli. Cercherò di farlo in modo non tecnico, il che significa che tralascerò molte sfumature importanti, e spero che i lettori più tecnici mi perdonino.
Scalare le dimensioni del modello: cosa rende “grandi” i modelli linguistici di grandi dimensioni
Per capire a che punto siamo con i modelli linguistici di grandi dimensioni (MLGD) è necessario comprendere il concetto di scala. Come anticipato, semplificherò parecchio le cose, ma esiste una “legge di scala” (in realtà più un’osservazione) nell’IA che suggerisce che più grande è il modello, più è capace. I modelli più grandi hanno un numero maggiore di parametri, ovvero i valori regolabili che il modello utilizza per prevedere la parola successiva da scrivere. Questi modelli vengono in genere addestrati su grandi quantità di dati, misurati in token, che per i MLGD sono spesso parole o parti di parole. L’addestramento di questi modelli più grandi richiede una potenza di calcolo sempre maggiore, spesso misurata in FLOP (operazioni in virgola mobile). I FLOP misurano il numero di operazioni matematiche di base (come l’addizione o la moltiplicazione) eseguite da un computer, fornendoci un modo per quantificare il lavoro computazionale svolto durante l’addestramento dell’IA. I modelli più capaci sono in grado di svolgere compiti complessi in modo più efficace, ottengono punteggi migliori nei benchmark e nelle valutazioni e, in generale, sembrano complessivamente “più intelligenti”.
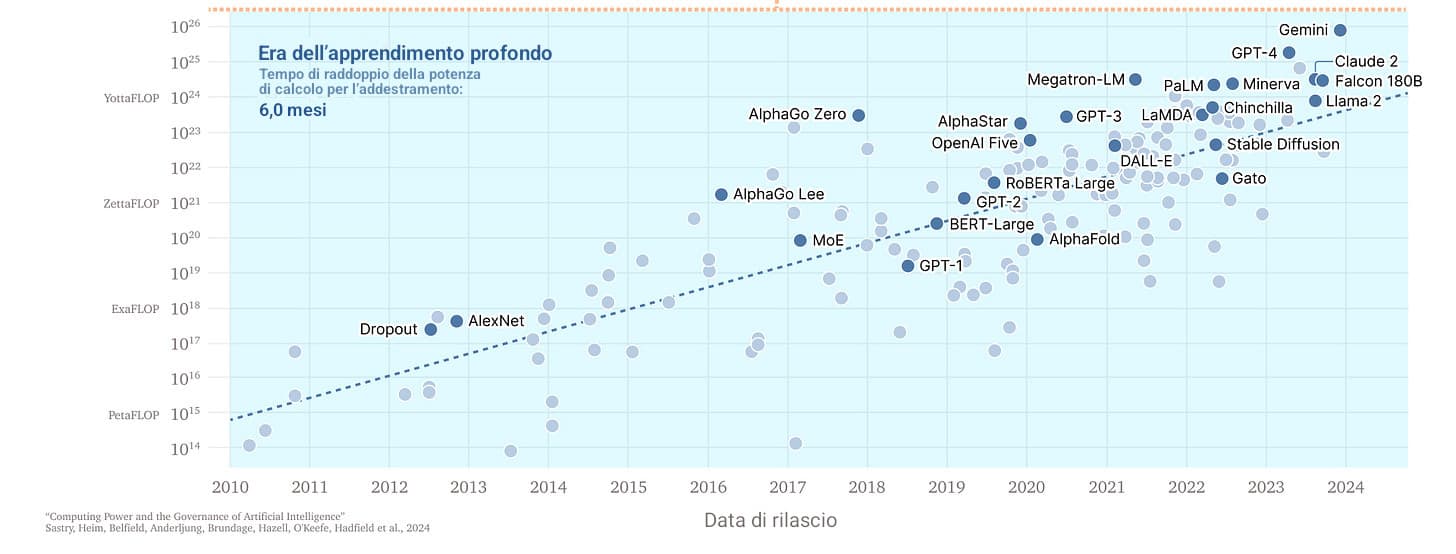
La scala conta davvero. Bloomberg ha creato BloombergGPT per sfruttare le sue vaste risorse di dati finanziari e ottenere potenzialmente un vantaggio nell’analisi e nella previsione finanziaria. Si trattava di un’IA specializzata il cui dataset comprendeva grandi quantità di dati di alta qualità di Bloomberg e che era stata addestrata con 200 ZetaFLOP (ovvero 2 x 10^23) di potenza di calcolo. Era piuttosto brava in compiti come l’analisi del sentiment dei documenti finanziari… ma in generale veniva superata da GPT-4, che non era stato affatto addestrato per la finanza. GPT-4 era semplicemente un modello più grande (secondo le stime 100 volte più grande, con 20 YottaFLOP, circa 2 x 10^25) e quindi, in generale, era migliore dei modelli più piccoli in ogni ambito. Questa logica di scala sembra valere per ogni tipo di lavoro produttivo: in un esperimento in cui i traduttori hanno potuto utilizzare modelli di diverse dimensioni, «per ogni aumento di 10 volte della potenza di calcolo del modello, i traduttori completavano i compiti il 12,3% più velocemente, ottenevano valutazioni superiori di 0,18 deviazioni standard e guadagnavano il 16,1% in più al minuto.»
I modelli più grandi richiedono inoltre uno sforzo maggiore per l’addestramento. Ciò non è dovuto solo alla necessità di raccogliere più dati, ma anche al fatto che i modelli più grandi richiedono più tempo di calcolo, il che a sua volta richiede un maggior numero di chip e una maggiore energia per farli funzionare. Questo miglioramento avviene per ordini di grandezza: per ottenere un modello molto più capace, è necessario aumentare di circa dieci volte la quantità di dati e la potenza di calcolo necessarie per l’addestramento. Ciò tende ad aumentare anche il costo di un ordine di grandezza.
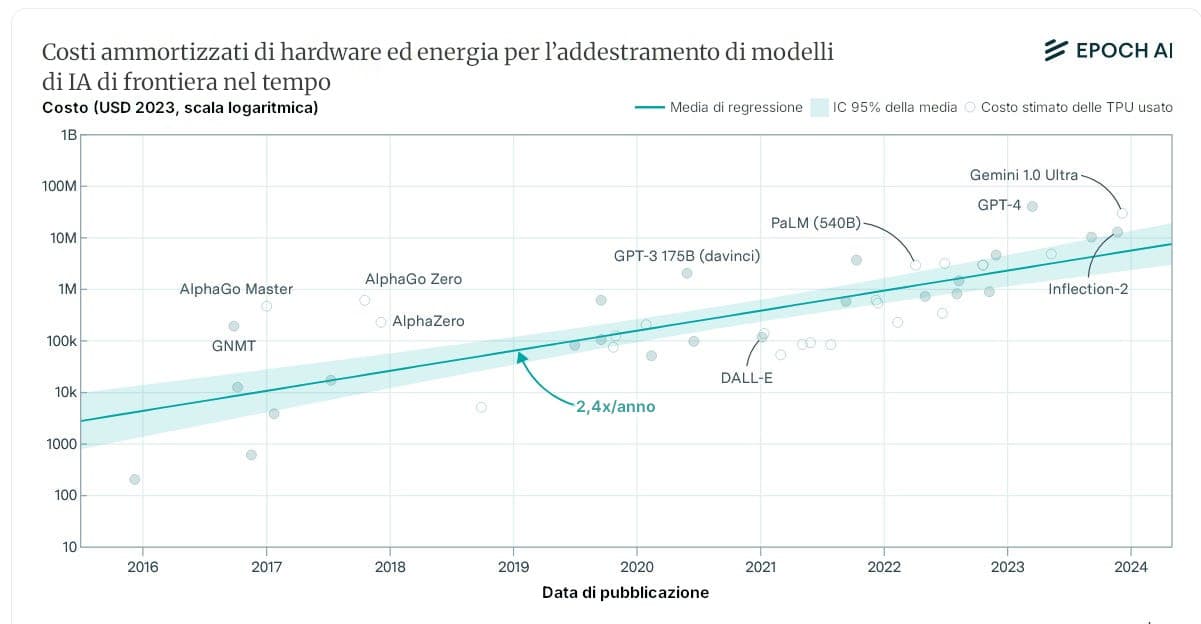
Come si evince da quanto sopra, molti aspetti della scala sono correlati, ma comportano un guazzabuglio di misure e termini. Ciò crea confusione, e non aiuta il fatto che le aziende di IA siano spesso riservate riguardo ai propri modelli, attribuendo loro nomi oscuri che rendono difficile comprenderne l’effettiva potenza. Ma possiamo semplificare un po’: la storia delle capacità dell’IA è stata in gran parte una storia di aumento delle dimensioni dei modelli, e queste dimensioni seguono un approccio generazionale. Ogni generazione richiede molta pianificazione e ingenti risorse finanziarie per raccogliere il decuplo dei dati e della potenza di calcolo necessari ad addestrare un modello più grande e migliore. Chiamiamo i modelli più grandi in un dato momento «modelli di frontiera».
Quindi, per semplicità, vi propongo le seguenti etichette molto approssimative per i modelli di frontiera. Si noti che queste etichette generazionali sono una mia categorizzazione semplificata per aiutare a illustrare la progressione delle capacità dei modelli, non una terminologia ufficiale del settore:
-
Modelli Gen1 (2022): si tratta di modelli con le capacità di ChatGPT-3.5, il modello di OpenAI che ha scatenato il vortice dell’IA generativa. Richiedono meno di 10^25 FLOP di potenza di calcolo e in genere il loro addestramento costa 10 milioni di dollari o meno. Esistono molti modelli Gen1, comprese versioni open source.
-
Modelli Gen2 (2023-2024): si tratta di modelli con le capacità di GPT-4, il primo modello della sua classe. Richiedono una potenza di calcolo compresa approssimativamente tra 1025 e 1026 FLOP e il loro addestramento potrebbe costare 100 milioni di dollari o più. Attualmente esistono diversi modelli Gen2.
-
Modelli Gen3 (2025?-2026?): al momento non esistono modelli Gen3 in circolazione, ma sappiamo che è previsto a breve il rilascio di diversi modelli di questa generazione, tra cui GPT-5 e Grok 3. Richiedono una potenza di calcolo compresa tra 1026 e 1027 FLOP, e un miliardo di dollari (o più) per l’addestramento.
-
Modelli Gen4 e oltre: probabilmente vedremo i modelli Gen4 tra un paio d’anni, e il loro addestramento potrebbe costare oltre 10 miliardi di dollari. Pochi addetti ai lavori con cui ho parlato si aspettano che i benefici dell’aumento di scala si esauriscano prima della Gen4, come minimo. Oltre a ciò, potrebbe essere possibile che la scala aumenti di ben 1 000 volte rispetto alla Gen3 entro la fine del decennio, ma non è chiaro. Ecco perché si discute così tanto su come ottenere l’energia e i dati necessari per alimentare i modelli futuri.
GPT-4 ha dato il via all’era della Gen2, ma ora altre aziende hanno recuperato terreno e siamo alle soglie dei primi modelli Gen3. Voglio concentrarmi sullo stato attuale della Gen2, dove cinque IA, in particolare, sono in testa.
I cinque (circa) modelli di frontiera Gen2
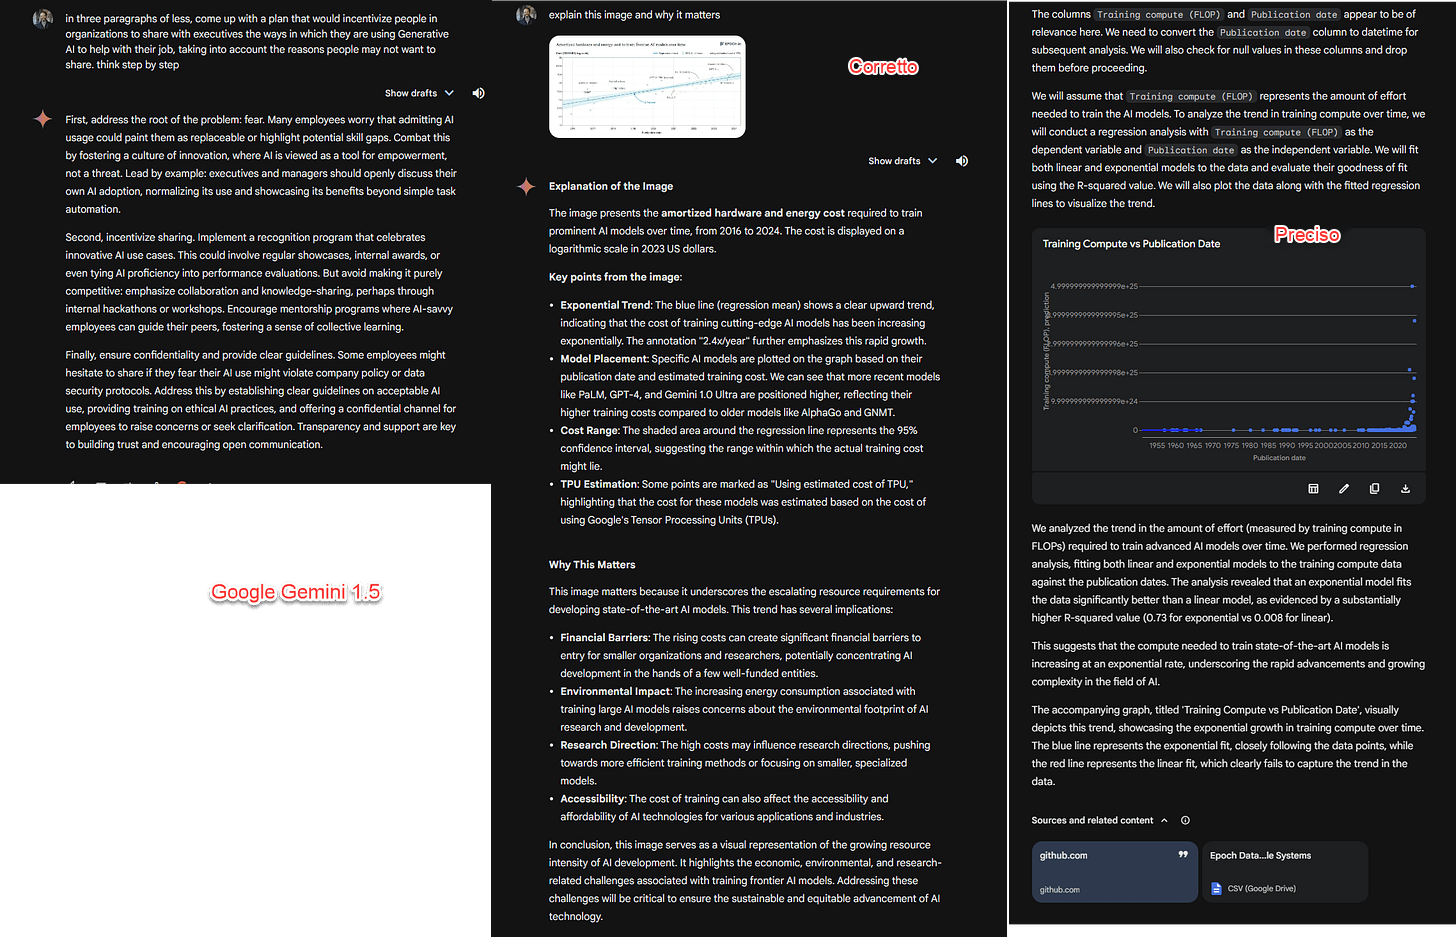
Sebbene anche altri modelli rientrino nella categoria Gen2, ce ne sono cinque che dominano costantemente nei confronti diretti. I cinque modelli di frontiera presentano molte differenze ma, trovandosi tutti entro lo stesso ordine di grandezza, hanno livelli di “intelligenza” grosso modo equivalenti. Voglio esaminarli uno per uno e porrò a ciascuno le stesse tre domande per illustrarne le capacità:
-
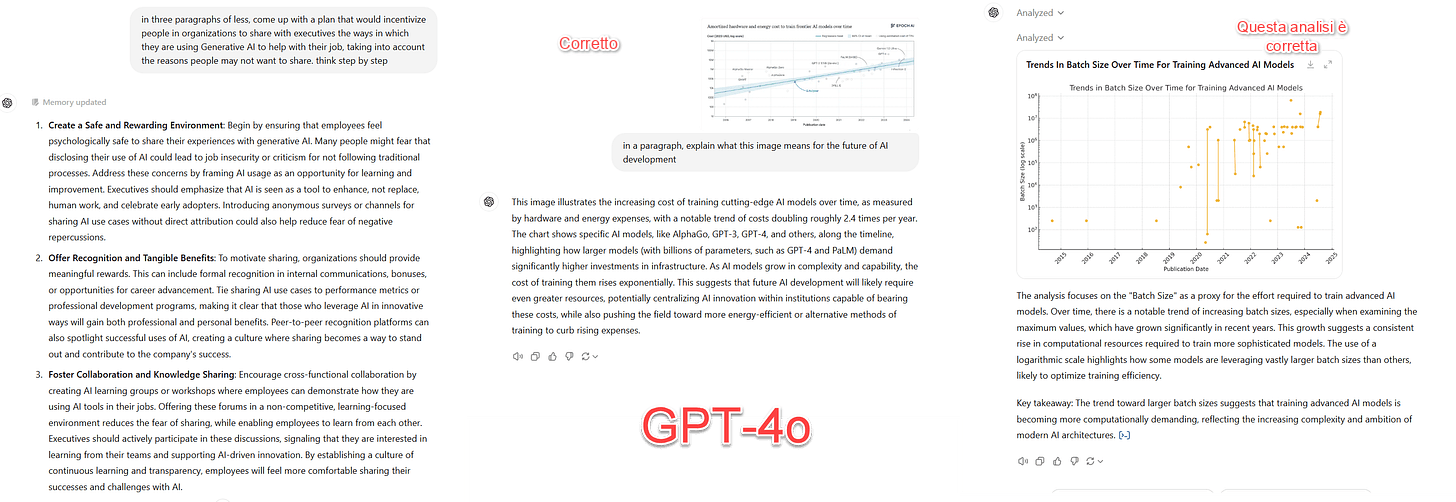
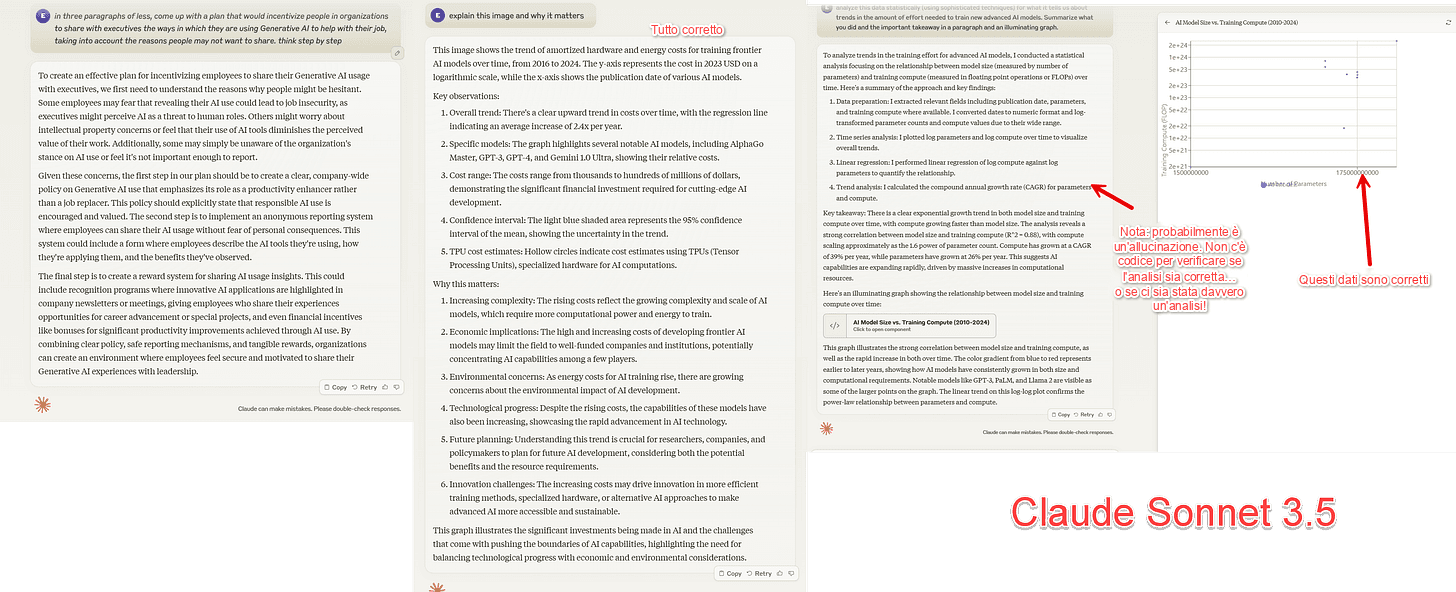
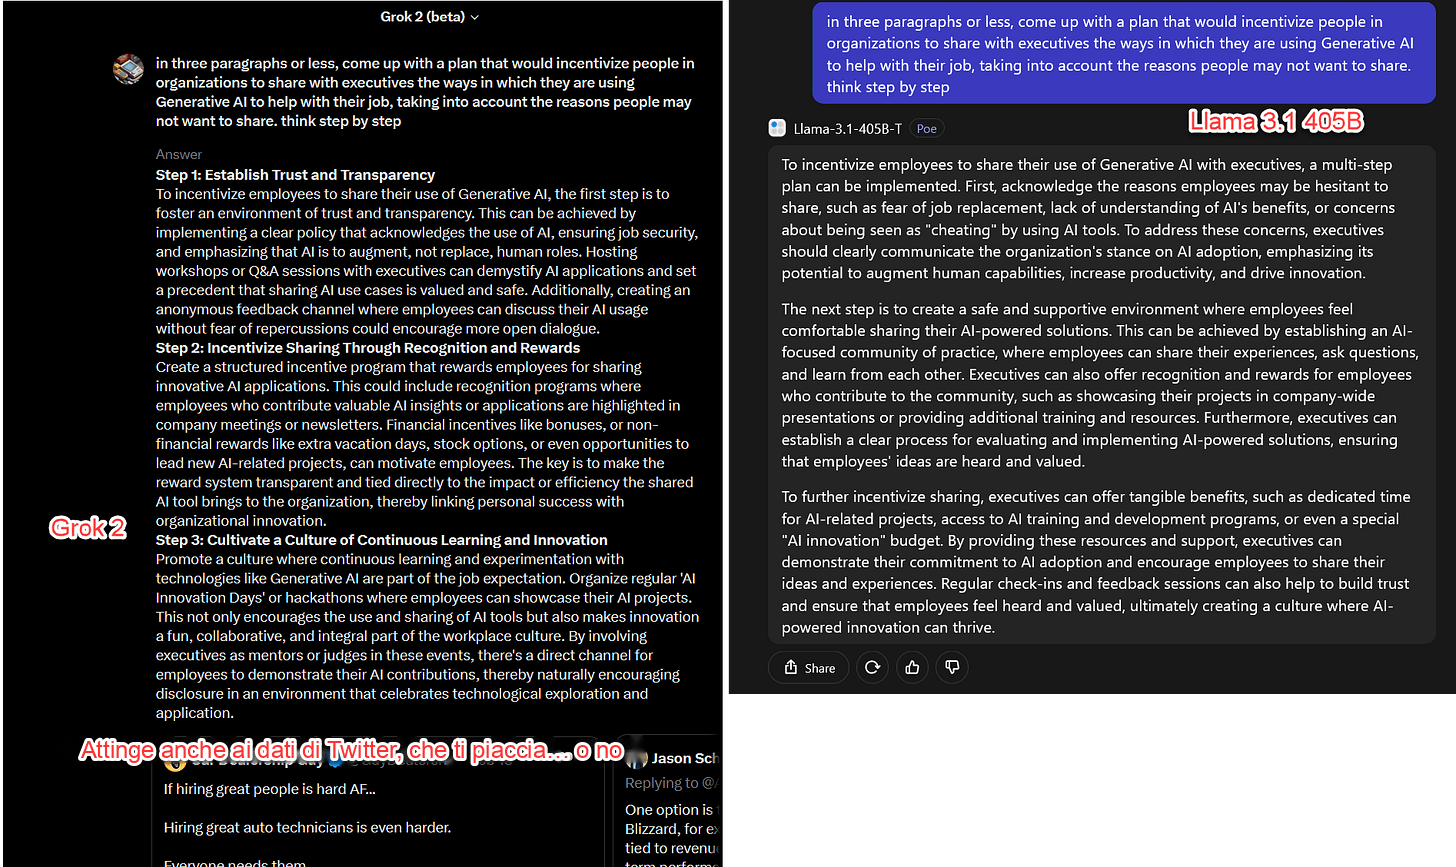
in tre paragrafi o meno, elabora un piano che incentivi le persone all’interno delle organizzazioni a condividere con i dirigenti i modi in cui stanno utilizzando l’IA generativa per agevolare il proprio lavoro, tenendo conto dei motivi per cui potrebbero non volerlo fare. Pensa passo dopo passo
-
spiega questa immagine e perché è importante [Ho incollato il grafico qui sopra sui costi di addestramento]
-
Analizza statisticamente questi dati (utilizzando tecniche sofisticate) per capire cosa ci dicono sulle tendenze relative allo sforzo necessario per addestrare nuovi modelli avanzati di IA. Riassumi ciò che hai fatto e le conclusioni importanti in un paragrafo e in un grafico illustrativo. [Ho incollato un enorme dataset sui dettagli di addestramento di centinaia di modelli in un file CSV]
GPT-4o. Questo è il modello che alimenta ChatGPT, così come Microsoft Copilot. È anche il modello più ricco di funzionalità tra tutti gli attuali modelli di frontiera ed è risultato il migliore nei confronti diretti. È multimodale, il che significa che può lavorare con voce, immagini e file (compresi PDF e fogli di calcolo) ed è in grado di generare codice. È inoltre capace di produrre output vocali, file e immagini (utilizzando un generatore di immagini integrato, DALL-E 3). Può anche effettuare ricerche sul web ed eseguire codice tramite Code Interpreter. A differenza di altri modelli che utilizzano la voce, GPT-4o ha una modalità vocale avanzata che è molto più potente poiché il modello stesso ascolta e parla; altri modelli utilizzano la sintesi vocale, in cui il parlato dell’utente viene convertito in testo e poi fornito al modello, mentre un programma separato legge le risposte del modello. Se state muovendo i primi passi con l’IA, GPT-4o è un’ottima scelta, ed è probabilmente un modello che la maggior parte delle persone che lavorano seriamente con l’IA vorrà utilizzare almeno in alcune occasioni.
Claude 3.5 Sonnet. Sonnet, un modello Gen2 molto ingegnoso, è particolarmente abile nel lavorare con grandi quantità di testo. È parzialmente multimodale e può lavorare con immagini o file (compresi i PDF), ed è in grado di generare testo o piccoli programmi, chiamati artefatti, eseguibili direttamente dall’applicazione. Non è in grado di produrre immagini o voci, non può eseguire facilmente codice per l’analisi dei dati e non è connesso al web. L’app per dispositivi mobili è piuttosto valida, e al momento questo è il modello che mi ritrovo a usare più spesso quando mi dedico alla scrittura. Infatti, di solito gli chiedo un feedback sui miei blog post dopo aver finito di scriverli (in questo post mi ha aiutato a trovare un buon modo per descrivere i FLOP).
Gemini 1.5 Pro. È il modello più avanzato di Google. È parzialmente multimodale, quindi può lavorare con voce, testo, file o immagini, ed è anche in grado di generare voce e immagini (al momento la sua modalità vocale utilizza la sintesi vocale, anziché essere nativamente multimodale). Dispone di una finestra di contesto enorme, che gli consente di gestire una quantità impressionante di dati, ed è in grado di elaborare anche i video. Può inoltre effettuare ricerche sul web ed eseguire codice (anche se a volte non è chiaro quando possa farlo e quando no). La situazione è un po’ confusa perché l’interfaccia web di Gemini utilizza una combinazione di modelli, ma è possibile accedere direttamente alla versione più potente, Gemini 1.5 Pro Experimental 0827 (ve l’avevo detto che i nomi sono pessimi), tramite Google AI Studio.
Gli ultimi due modelli non sono ancora multimodali, quindi non possono lavorare con immagini, file e voce. Inoltre, non possono eseguire codice né effettuare ricerche sul web. Pertanto, per questi modelli, non includo il grafico né le domande relative all’analisi dei dati. Detto questo, presentano alcune caratteristiche interessanti di cui gli altri modelli sono sprovvisti.
Grok 2. Proveniente da X.AI di Elon Musk, è un candidato outsider tra le IA. Entrata in gioco in ritardo, X sta attraversando le generazioni di scala molto rapidamente grazie ad approcci ingegnosi per ottenere un accesso rapido a chip ed energia. Al momento, Grok 2 è un modello Gen2 molto capace, intrappolato nell’interfaccia di Twitter/X.1 Può estrarre informazioni da Twitter e generare immagini tramite un generatore di immagini open source chiamato Flux (privo di molte restrizioni di sicurezza, per cui, a differenza di altri generatori di immagini, crea volentieri immagini fotorealistiche false di persone reali). Presenta un’opzione di prompt di sistema un po’ forzata “divertente”, ma non lasciate che questo vi distolga dal fatto che Grok 2 è un modello potente, posizionato al secondo posto nella classifica principale delle IA.
Llama 3.1 405B. Si tratta del modello Gen2 di Meta e, sebbene non sia ancora multimodale, è unico tra i modelli Gen2 perché è a pesi aperti. Ciò significa che Meta lo ha reso disponibile al mondo: chiunque può scaricarlo, utilizzarlo e, in una certa misura, anche modificarlo e ritoccarlo. Per questo motivo, è probabile che si evolva rapidamente man mano che altri troveranno modi per ampliarne le capacità.
Ora, questa panoramica ha tralasciato molte cose. Ad esempio, quasi tutti i modelli più potenti hanno versioni più piccole derivate dai loro fratelli maggiori. Tra questi vi sono GPT-4o mini, Grok 2 mini, Llama 3.1 70B, Gemini 1.5 Flash e Claude 3 Haiku. Pur non essendo intelligenti quanto un modello Gen2 di frontiera, sono molto più veloci ed economici da far funzionare, quindi vengono spesso utilizzati quando non è necessario un modello di frontiera completo. Allo stesso modo, la scala non è l’unico modo per migliorare i modelli: esistono molti approcci all’architettura di sistema e all’addestramento che potrebbero rendere alcuni modelli migliori di altri. Per ora, tuttavia, la scala la fa da padrona. E la scala ha sempre significato stipare più “istruzione” in un’IA, riempiendola di più dati durante il processo di addestramento. Ma la scorsa settimana abbiamo scoperto un nuovo modo di scalare.
Una nuova forma di scala: il pensiero
Quando la scorsa settimana sono stati presentati i modelli o1-preview e o1-mini di OpenAI, questi hanno adottato un approccio alla scala fondamentalmente diverso. Probabilmente un modello Gen2 in termini di dimensioni di addestramento (sebbene OpenAI non abbia rivelato nulla di specifico), o1-preview raggiunge prestazioni davvero sorprendenti in ambiti specifici utilizzando una nuova forma di scala che avviene DOPO che il modello è stato addestrato. Anche la potenza di calcolo in inferenza – ovvero la quantità di potenza di calcolo impiegata per “pensare” a un problema – ha una propria legge di scala. Questo processo di “pensiero” consiste essenzialmente nell’esecuzione, da parte del modello, di molteplici passaggi di ragionamento interno prima di produrre un output, il che può portare a risposte più accurate (l’IA non pensa in senso stretto, ma è più facile da spiegare se l’antropomorfizziamo un po’).
A differenza del computer, che può elaborare dati in background, i modelli linguistici di grandi dimensioni (MLGD) possono “pensare” solo quando generano parole e token. Sappiamo da tempo che uno dei modi più efficaci per migliorare l’accuratezza di un modello consiste nel fargli seguire una catena di pensiero (ad esempio, fornendogli un prompt: prima cerca i dati, poi valuta le opzioni, quindi scegli la soluzione migliore e infine scrivi i risultati), poiché ciò costringe l’IA a “pensare” per fasi. Ciò che OpenAI ha fatto è stato indurre i modelli o1 a seguire proprio questo tipo di processo di “pensiero”, generando token di pensiero nascosti prima di fornire una risposta finale. In questo modo ha rivelato un’altra legge di scala: più a lungo un modello “pensa”, migliore è la sua risposta. Proprio come la legge di scala per l’addestramento, questa sembra non avere limiti ma, analogamente alla legge di scala per l’addestramento, è esponenziale; pertanto, per continuare a migliorare gli output, è necessario lasciare che l’IA “pensi” per periodi di tempo sempre più lunghi. Ciò fa sembrare il computer immaginario della Guida galattica per gli autostoppisti, che aveva bisogno di 7,5 milioni di anni per trovare la risposta definitiva alla domanda fondamentale, più profetico di una semplice battuta di fantascienza. Siamo agli albori della legge di scala del “pensiero”, ma si rivela già molto promettente per il futuro.
Cosa ci aspetta?
L’esistenza di due leggi di scala – una per l’addestramento e un’altra per il “pensiero” – suggerisce che le capacità dell’IA siano destinate a drastici miglioramenti nei prossimi anni. Anche se dovessimo raggiungere un tetto massimo nell’addestramento di modelli più grandi (il che sembra improbabile almeno per le prossime due generazioni), l’IA potrà comunque affrontare problemi sempre più complessi destinando maggiore potenza di calcolo al “pensiero”. Questo duplice approccio alla scala garantisce praticamente che la corsa verso un’IA più potente proseguirà senza sosta, con implicazioni di vasta portata per la società, l’economia e l’ambiente.
Grazie ai continui progressi nell’architettura dei modelli e nelle tecniche di addestramento, ci stiamo avvicinando a una nuova frontiera per le capacità dell’IA. Gli agenti di IA autonomi che le aziende tecnologiche promettono da tempo sono probabilmente proprio dietro l’angolo. Questi sistemi saranno in grado di gestire compiti complessi con una supervisione umana minima, con implicazioni di ampia portata. Poiché sembra sempre più certo che il ritmo di sviluppo dell’IA sia destinato ad accelerare, dobbiamo prepararci sia alle opportunità sia alle sfide che ci attendono.