Il momento più importante della storia è proprio adesso
L’IAG sta arrivando prima del previsto grazie a o3, DeepSeek e ad altri sviluppi nell’IA all’avanguardia
L’IA sta progredendo così rapidamente che i ricercatori del settore sono nel panico. Ormai si dimostra regolarmente più intelligente degli esseri umani e la sua velocità di sviluppo sta accelerando. I nuovi sviluppi delle ultime settimane l’hanno accelerata ulteriormente. Ora sembra che le IA possano diventare più intelligenti degli esseri umani entro 1-5 anni e, poco dopo, intelligenti come divinità. Siamo sull’orlo del precipizio e stiamo per saltare nel baratro della superintelligenza dell’IA,1 che lo vogliamo o no.
Quando salteremo?
Cosa c’è in fondo?
Abbiamo un paracadute?
Previsioni di mercato
Sei mesi fa ho scritto What would you do if you had 8 years left to live?, in cui spiegavo che il mercato prevedeva l’intelligenza artificiale generale (IAG, cioè un’IA in grado di fare ciò che la maggior parte degli esseri umani sa fare) tra otto anni, entro il 2032. Da allora, quella data è stata anticipata. Ora si prevede che arriverà in soli sei anni, quindi sei mesi sono bastati per anticipare la data di un anno. Le probabilità ora si presentano così:
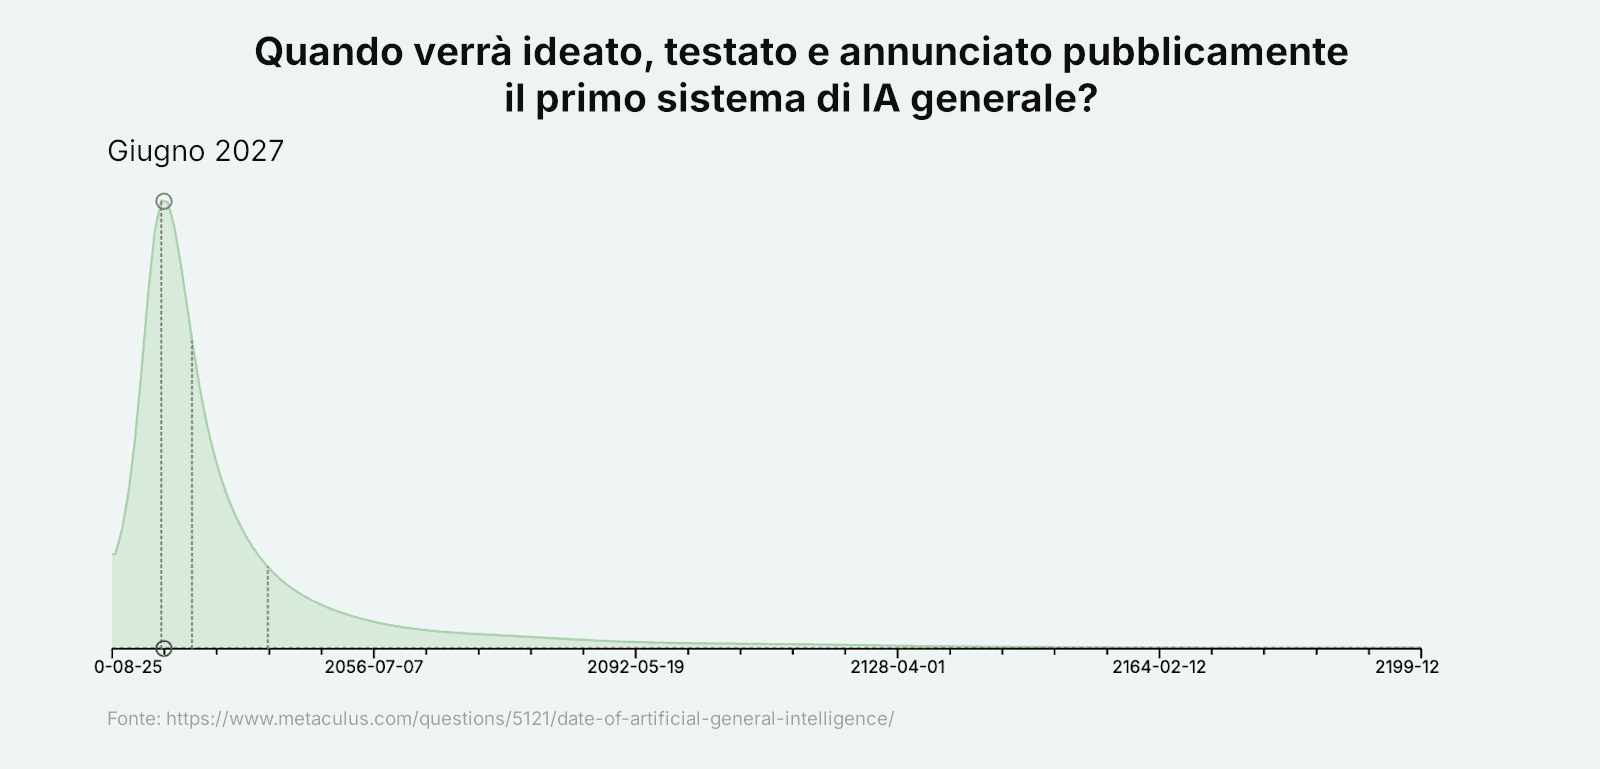
Ma un’IA pari all’intelligenza umana non è il traguardo più preoccupante. Quello più preoccupante è la SIA, la superintelligenza artificiale: un’intelligenza talmente superiore alle capacità umane da non riuscire nemmeno a comprenderla.
Secondo le previsioni, ciò avverrà tra cinque anni:
-
Due anni per un’IAG debole, quindi entro la fine del 2026
-
Tre anni dopo, la superintelligenza, quindi entro la fine del 2029
Come potete vedere, queste previsioni non sono perfettamente coerenti, ma sono allineate: un’IA in grado di svolgere qualsiasi compito meglio di qualsiasi essere umano è a mezzo decennio di distanza.
Chi è nella posizione migliore per saperlo con certezza? Immagino siano i responsabili dei più grandi laboratori di IA al mondo. Cosa dicono?
Esperti all’avanguardia
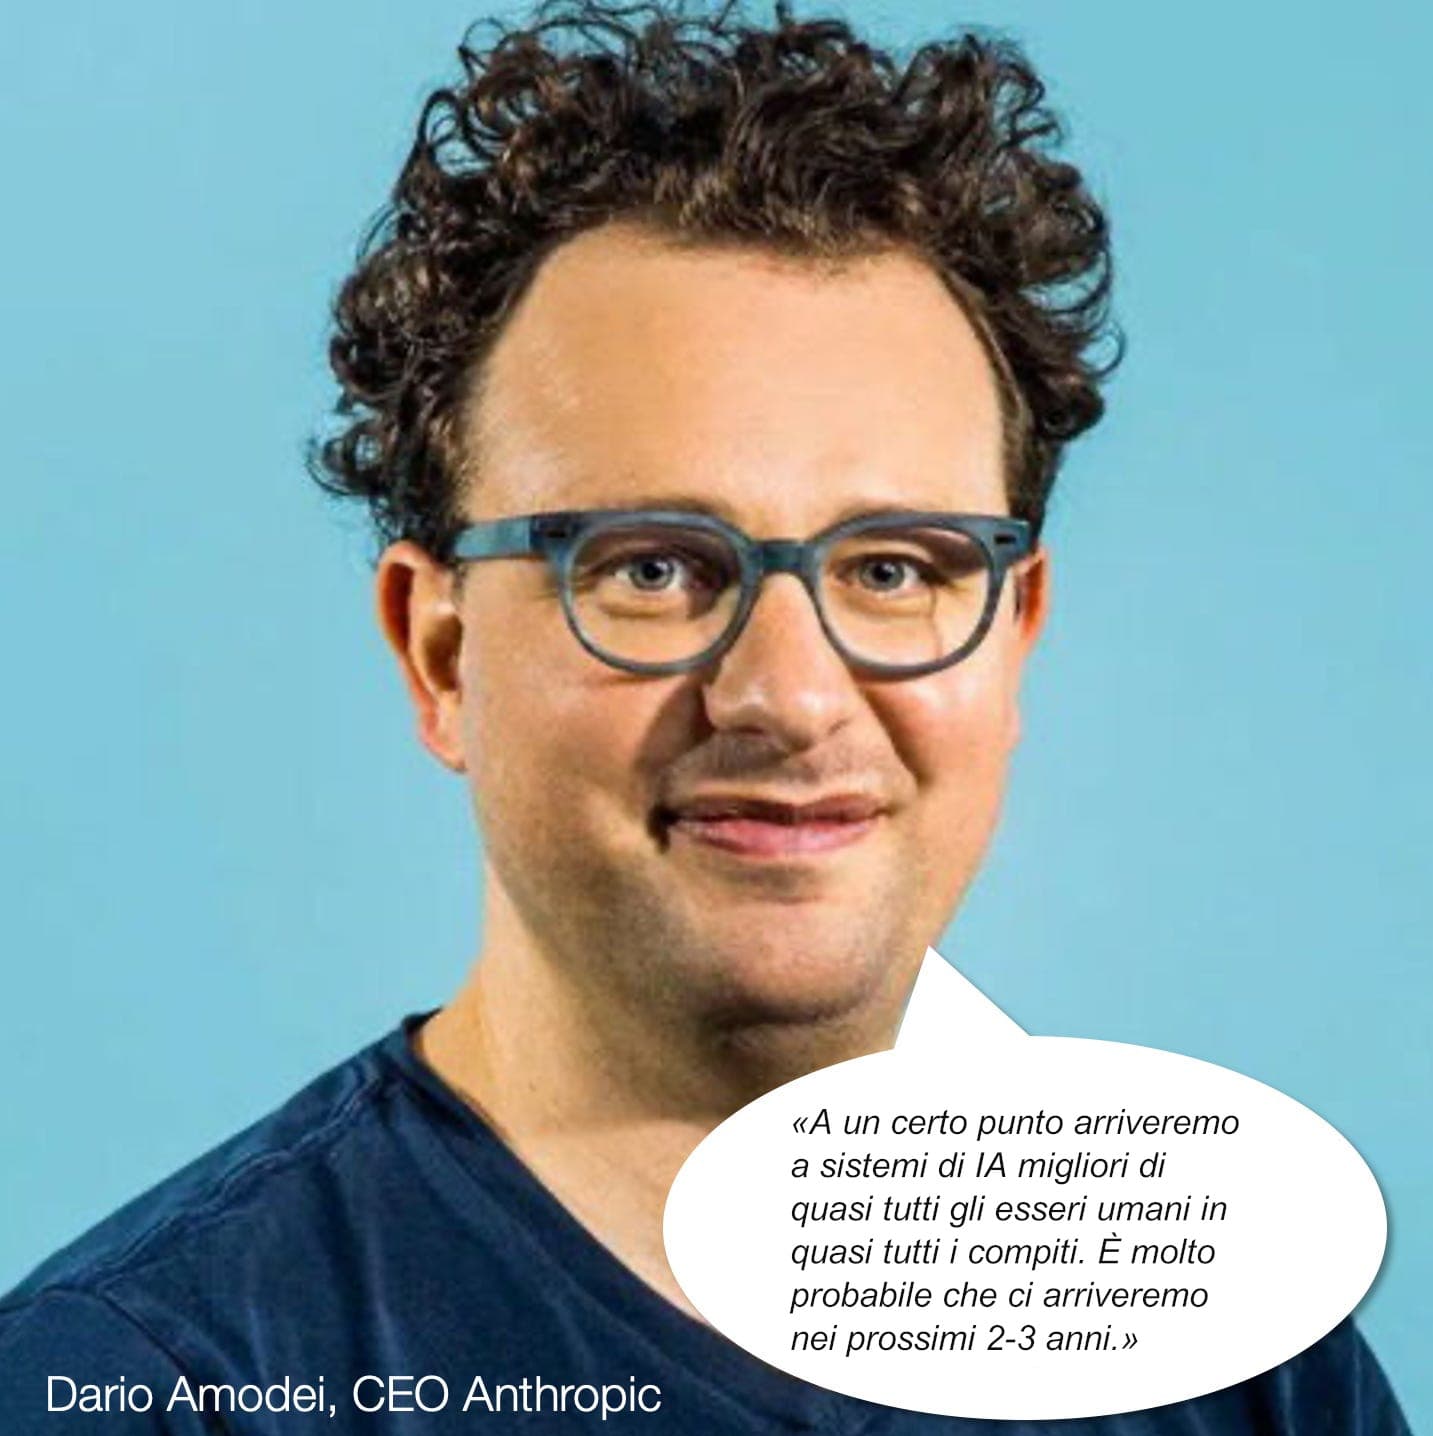
Ecco un’altra sua citazione:
Penso che un’IA potente2 potrebbe arrivare già nel 2026.—Macchine di amorevole grazia, Dario Amodei, amministratore delegato di Anthropic
E un’altra:
Due anni fa eravamo a livello di scuola superiore. L’anno scorso eravamo a livello universitario. Quest’anno siamo a livello di dottorato. Se si valuta a occhio il ritmo con cui queste capacità stanno aumentando, viene da pensare che ci arriveremo nel 2026 o nel 2027.—Dario Amodei da Lex Friedman
Passando a OpenAI, l’azienda creatrice di ChatGPT, ecco il suo amministratore delegato, Sam Altman:
Ora siamo certi di sapere come costruire un’IAG così come l’abbiamo tradizionalmente intesa. Stiamo iniziando a puntare oltre, verso la superintelligenza nel vero senso della parola. Con la superintelligenza, possiamo fare qualsiasi altra cosa.—Reflections, Sam Altman
Ecco il responsabile di prodotto:
L’IA passa dall’essere il milionesimo miglior programmatore, al millesimo, fino al 175° miglior programmatore in 3 o 4 mesi… Siamo su una traiettoria molto ripida qui, non so nemmeno se sarà nel 2027, penso che potrebbe accadere prima.
Perché sostiene che l’IA sia ora il 175° miglior programmatore al mondo?
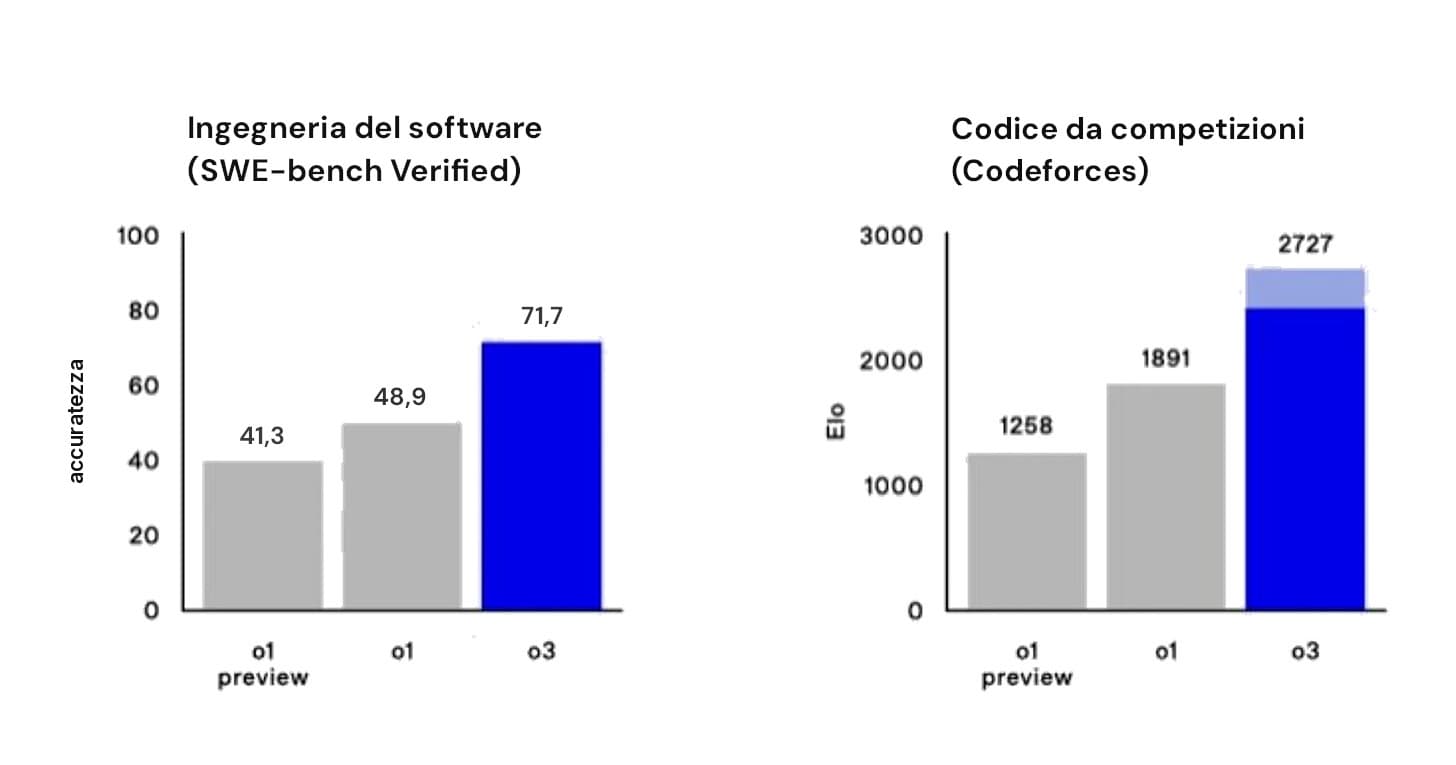
Si noti che sono i programmatori a sviluppare effettivamente l’IA. Quindi, se l’IA è attualmente il 175° miglior programmatore, allora l’IA può programmare l’IA meglio della maggior parte degli esseri umani stessi.
Ecco un ricercatore di OpenAI:
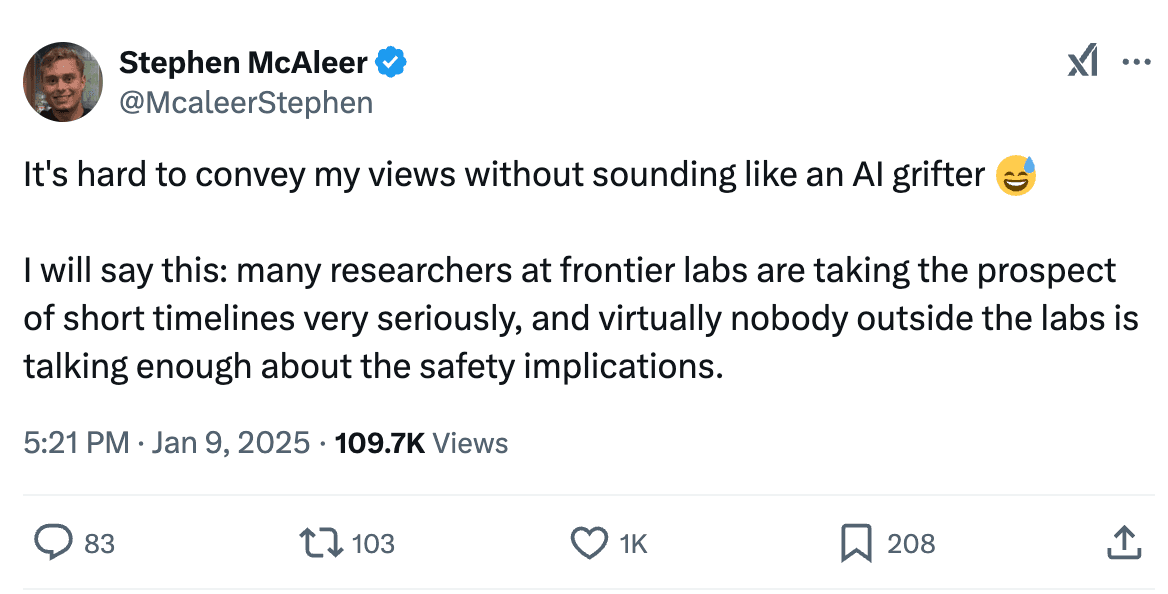
E un altro ancora:
Riteniamo che o1 [il modello rilasciato da OpenAI alcuni mesi fa] rappresenti un nuovo paradigma di scalabilità e siamo ancora agli inizi dello scaling lungo questa dimensione.—Noam Brown
Tutto ciò che stiamo facendo in questo momento è estremamente scalabile. Tutto è emergente. Nulla è predefinito. Non è stato fatto nulla per dire al modello: «Ehi, forse dovresti verificare la tua soluzione, dovresti tornare indietro…». Non è stata utilizzata alcuna tattica. Tutto è emergente. Tutto viene appreso attraverso l’apprendimento per rinforzo. È pazzesco! Una follia!
Da quando sono entrato nel gennaio 2024, sono passato da «questo è clamore improduttivo» a «l’IAG è praticamente qui». A mio modesto parere, quello che ci aspetta è relativamente poca nuova scienza e, piuttosto, anni di estenuante lavoro ingegneristico per testare tutte le idee appena diventate ovvie nel nuovo paradigma. Forse ci sarà un altro muro dopo questo, ma per ora si prospettano balzi di 10x a perdita d’occhio.
Ecco cosa ha detto al riguardo la Casa Bianca di Biden:
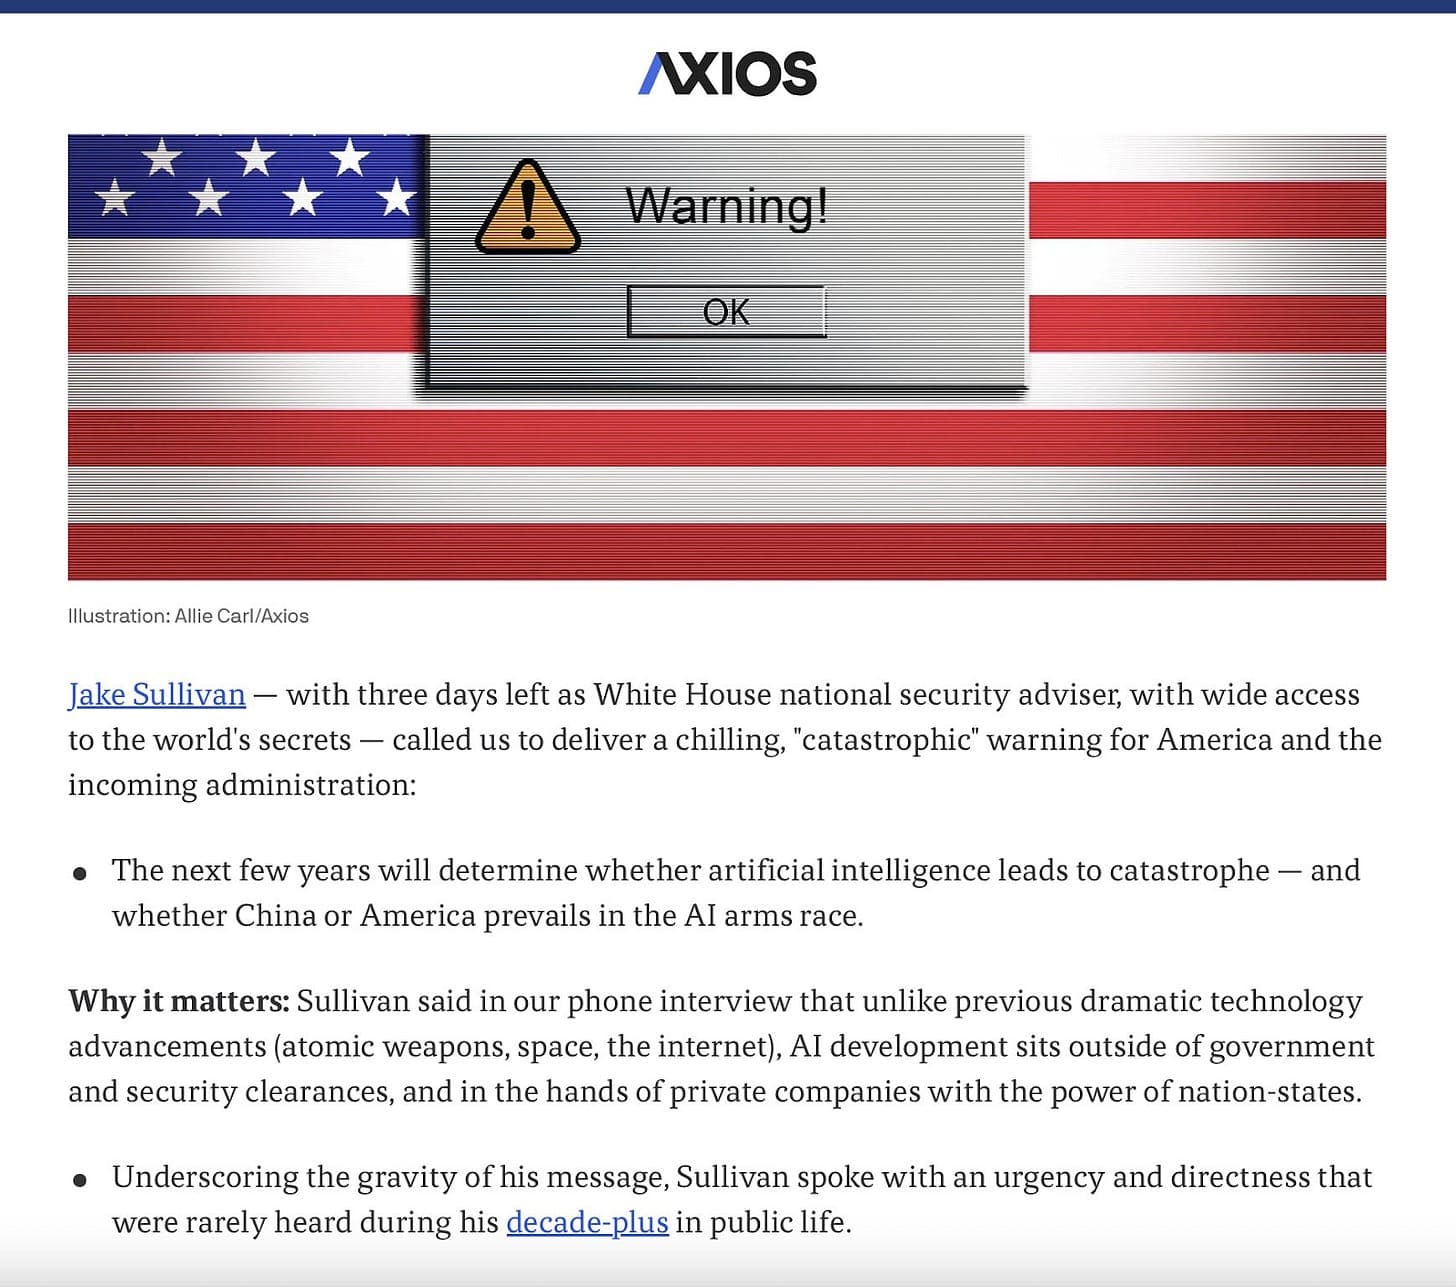
Potrebbe essere questo il motivo per cui Sam Altman ha fissato per il 30 gennaio un briefing a porte chiuse con i funzionari del governo statunitense. Da Axios:
Gli addetti ai lavori nel campo dell’IA ritengono che sia in arrivo una grande svolta sui SuperAgenti a livello di dottorato… I dipendenti di OpenAI hanno confidato agli amici di essere al tempo stesso entusiasti e intimoriti dai recenti progressi.
Se pensate che si tratti solo di sensazionalismo da parte dei leader dell’IA alla ricerca di nuovi investitori, considerate le parole di Demis Hassabis, recente vincitore del Premio Nobel per il suo lavoro sull’IA e amministratore delegato di DeepMind (parte di Google, quindi senza bisogno di raccogliere fondi):
C’è molto sensazionalismo in questo settore. [L’IAG è] probabilmente a tre-cinque anni di distanza.
Ma esistono prove concrete che questi modelli di IA stiano diventando così avanzati?
Benchmark
L’IA ha storicamente impiegato del tempo per superare gli esseri umani in diversi compiti.
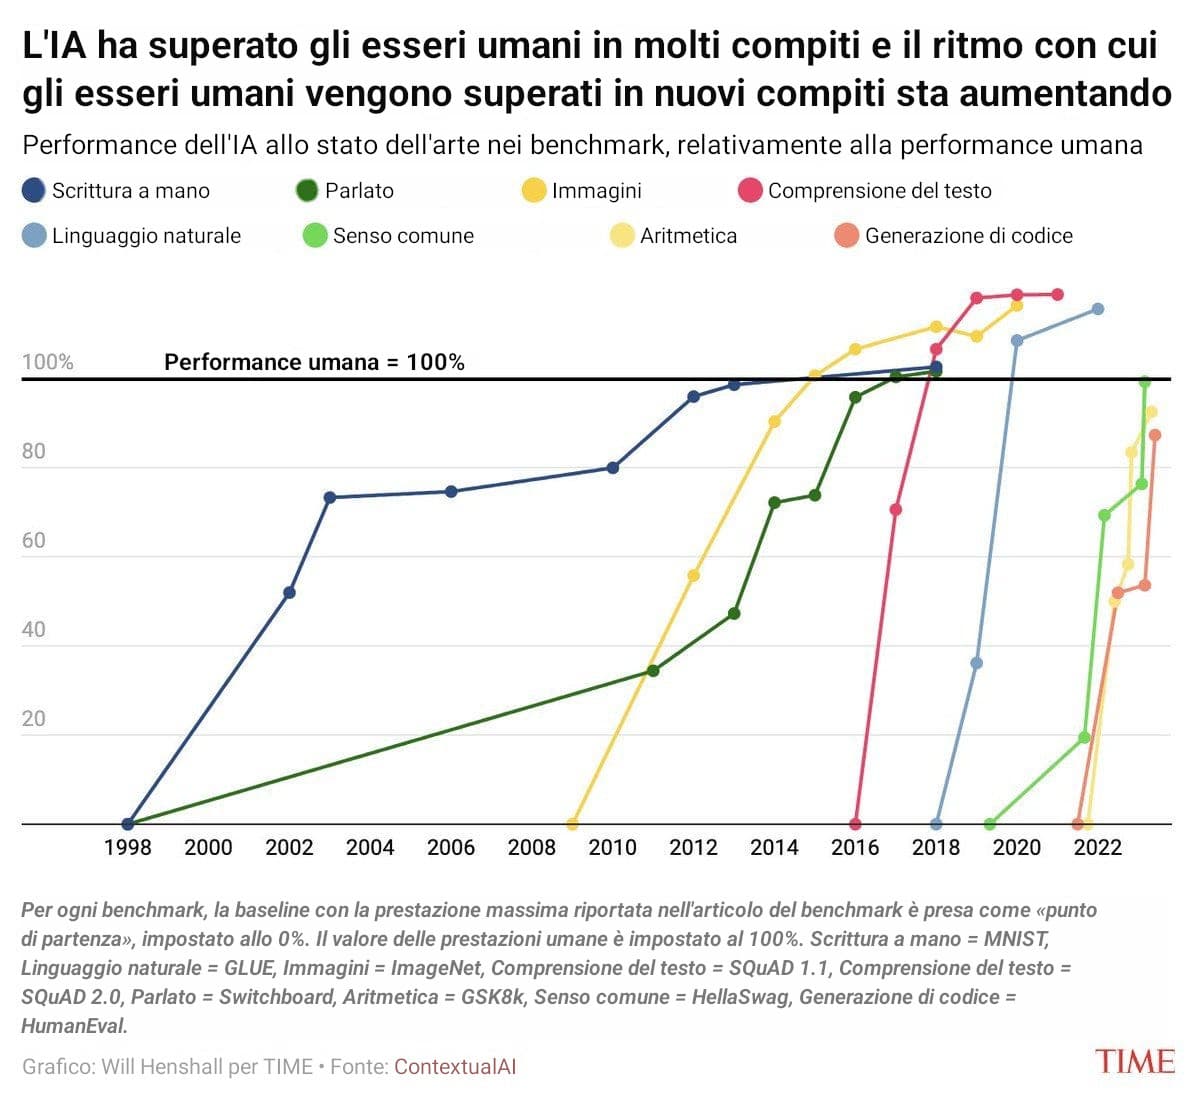
Ma se un tempo l’IA impiegava decenni per superare le prestazioni umane in un dato compito, ora bastano mesi. Ecco a che velocità si muovono le cose.
Il modello all’avanguardia di OpenAI, o3, non è ancora stato rilasciato, quindi vediamo cosa aveva da dire al riguardo chi ha utilizzato il ben più limitato o1.5
Secondo un test MENSA, ha un QI di 120.
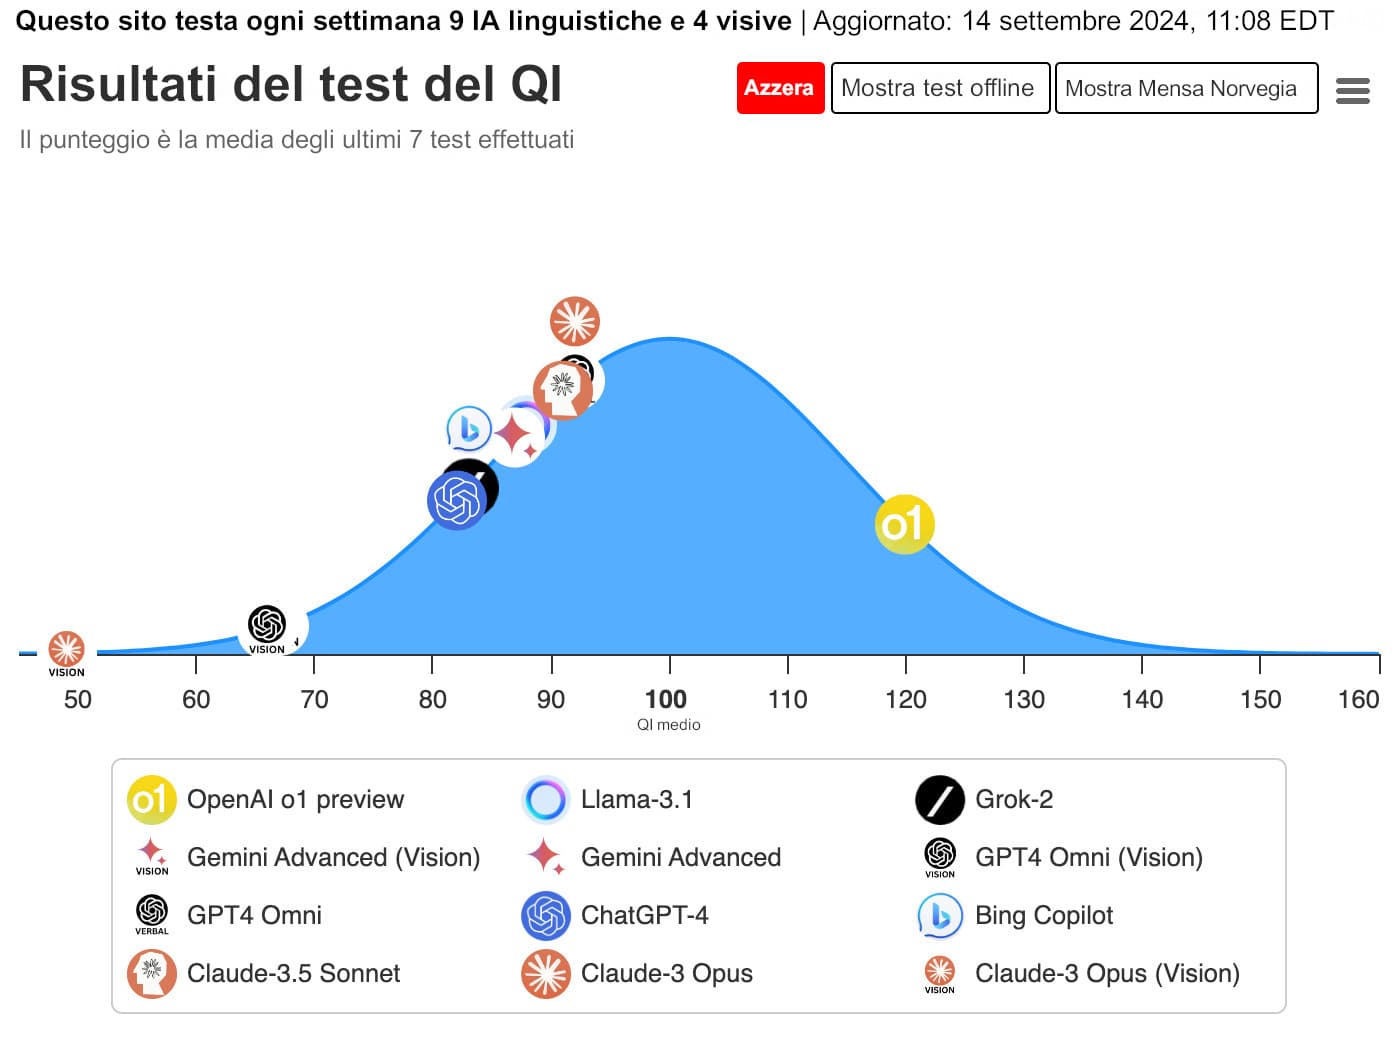
Per darvi un’idea di quanto sia intelligente, ciò collocherebbe o1 tra l’intelligenza superiore e l’intelligenza molto superiore, posizionandolo tra l’87° e il 91° percentile dell’intelligenza. In altre parole, questa cosa è più intelligente di 9 esseri umani su 10.
Pensateci.
Ecco un modo per farvene un’idea (provate a rispondere da soli alla domanda qui sotto!):
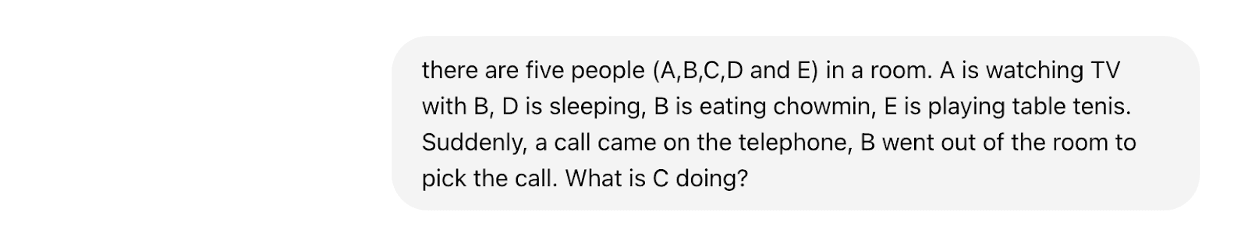
Allora, qual è la vostra risposta?
Pensateci!
OK, eccola qui:
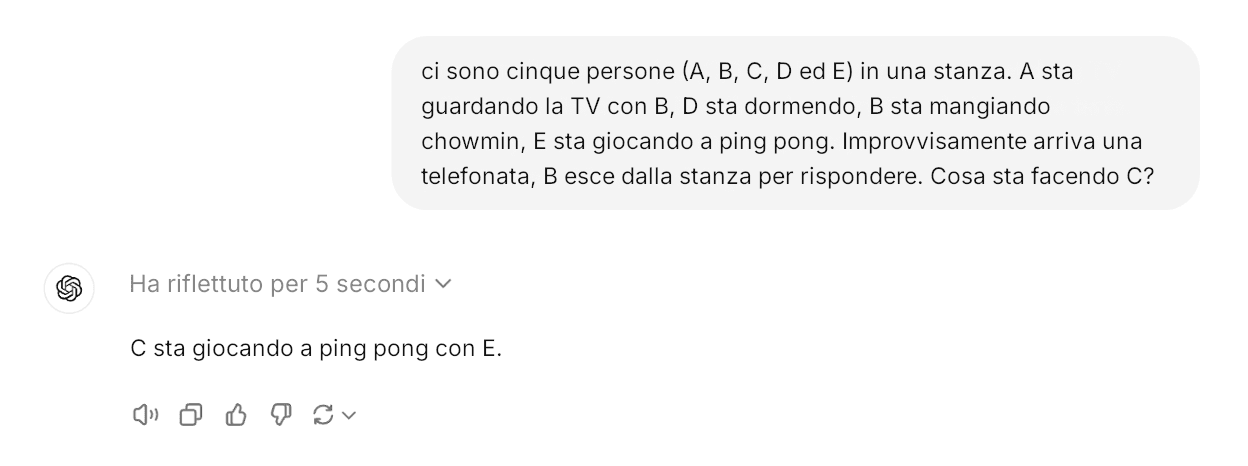
L’ho verificato in modo indipendente.7
A me ci sono voluti sicuramente più di 5 secondi per arrivarci, e immagino che molte persone non riescano affatto a risolverlo.
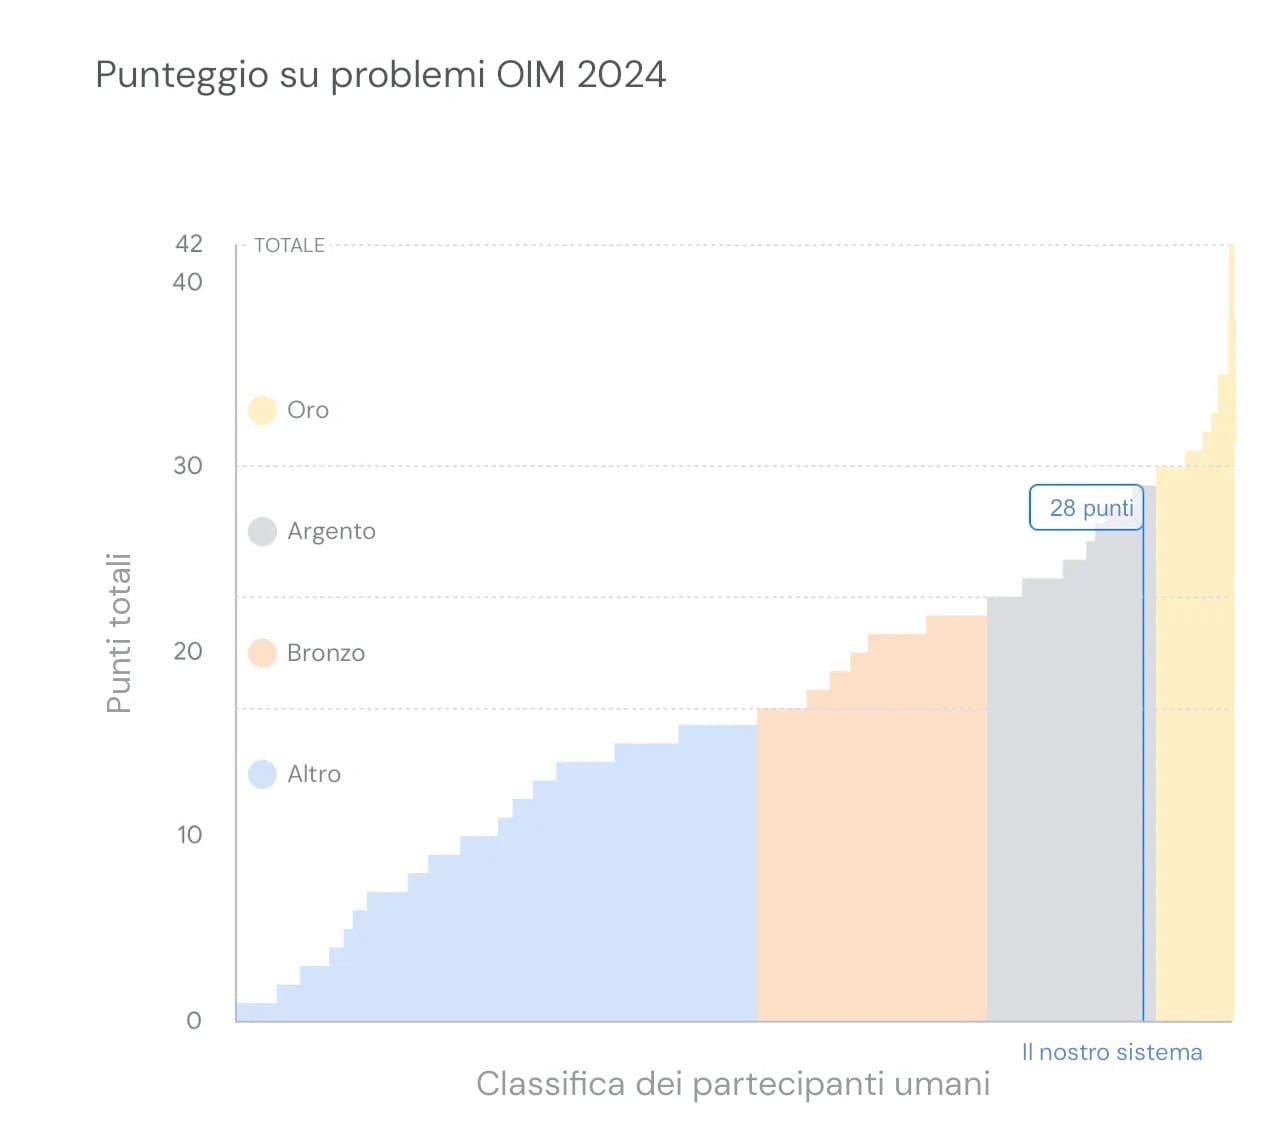
A luglio 2024, AlphaProof e AlphaGeometry di Google DeepMind hanno quasi conquistato l’oro alle Olimpiadi Internazionali di Matematica (OIM):
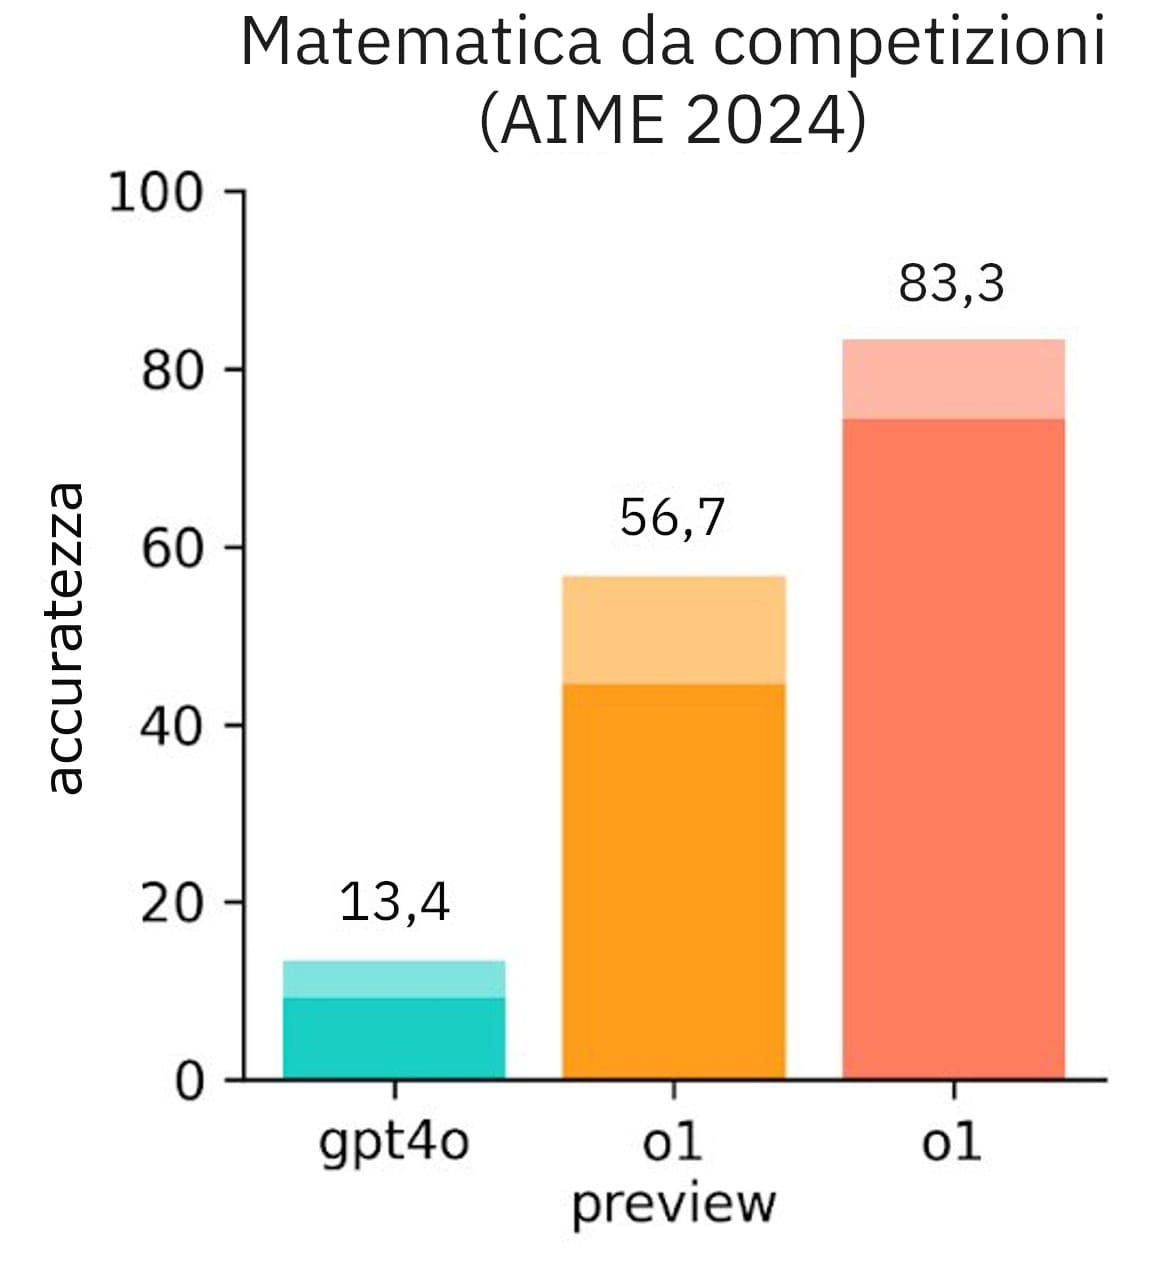
o1 è generalista. Non è specializzato in matematica. Eppure ha ottenuto un punteggio dell’83% in un esame di qualificazione per le stesse OIM. Il precedente ChatGPT aveva ottenuto il 13%…
Perché è importante?
Raggiungere l’oro alle OIM è una soglia per i ricercatori di IA, che lo interpretano come «essere in grado di ragionare».
Paul Christiano — inventore dell’apprendimento per rinforzo con feedback umano, genio certificato e probabilmente il ricercatore sull’allineamento più rispettato al mondo — aveva affermato in precedenza che avrebbe rivisto la probabilità di un decollo rapido dal 30% al 50% se avessimo visto un oro alle OIM entro il 2025.—@AISafetyMemes
Ricordiamo che un decollo rapido si verifica quando l’IA diventa abbastanza intelligente da migliorarsi e così fa, diventa più intelligente, si migliora ulteriormente, diventa ancora più intelligente e, FOOM, diventa superintelligente nel giro di mesi, settimane o giorni attraverso il suo ciclo ricorsivo di auto-miglioramento.
Se volete farvi un’idea, ascoltate l’amministratore delegato di NVIDIA — l’azienda che oggi realizza oltre il 100%8 dei profitti nel settore dell’IA:
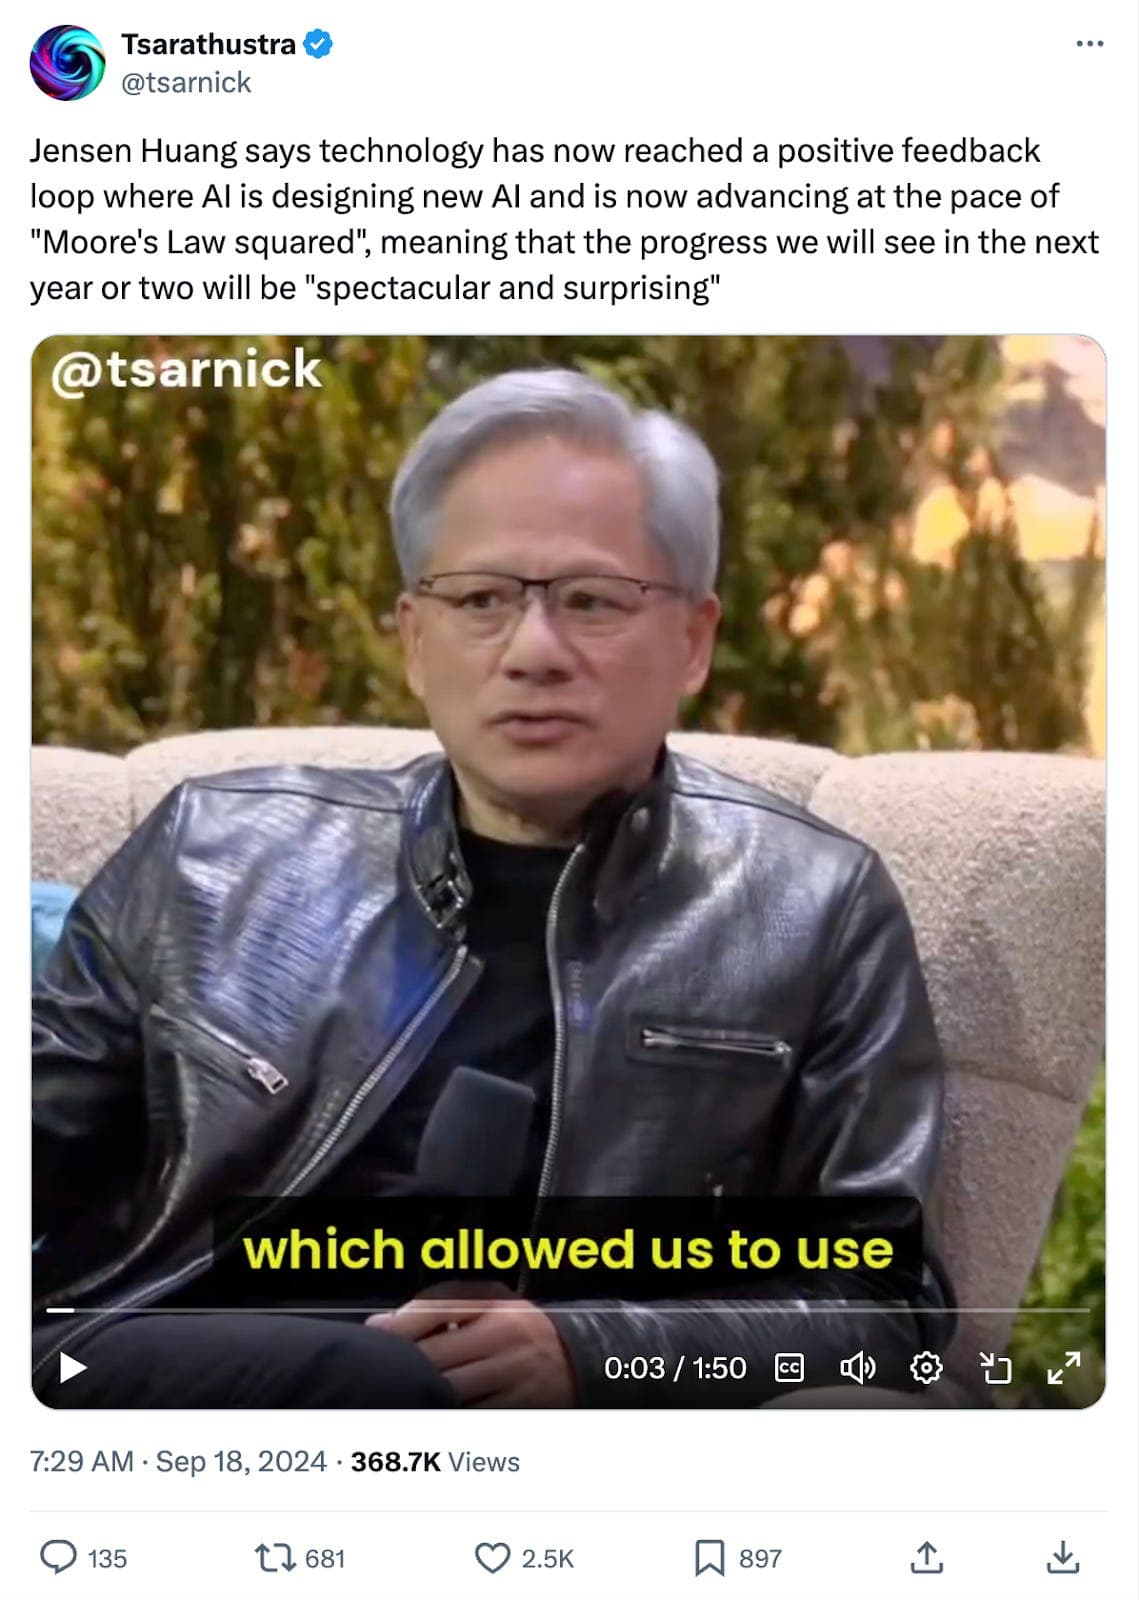
Nel 2021 Paul riteneva che ci fosse solo l’8% di probabilità che ciò accadesse! Era notoriamente il più famoso sostenitore del «decollo lento». I decolli rapidi fanno paura perché sono molto meno prevedibili. Le istituzioni umane non hanno quasi tempo per adattarsi a ritmi di cambiamento folli.—Fonte
Guardate come si comporta con domande scientifiche a livello di dottorato:
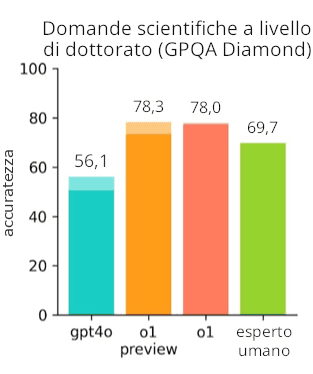
Risponde meglio dei dottori di ricerca!
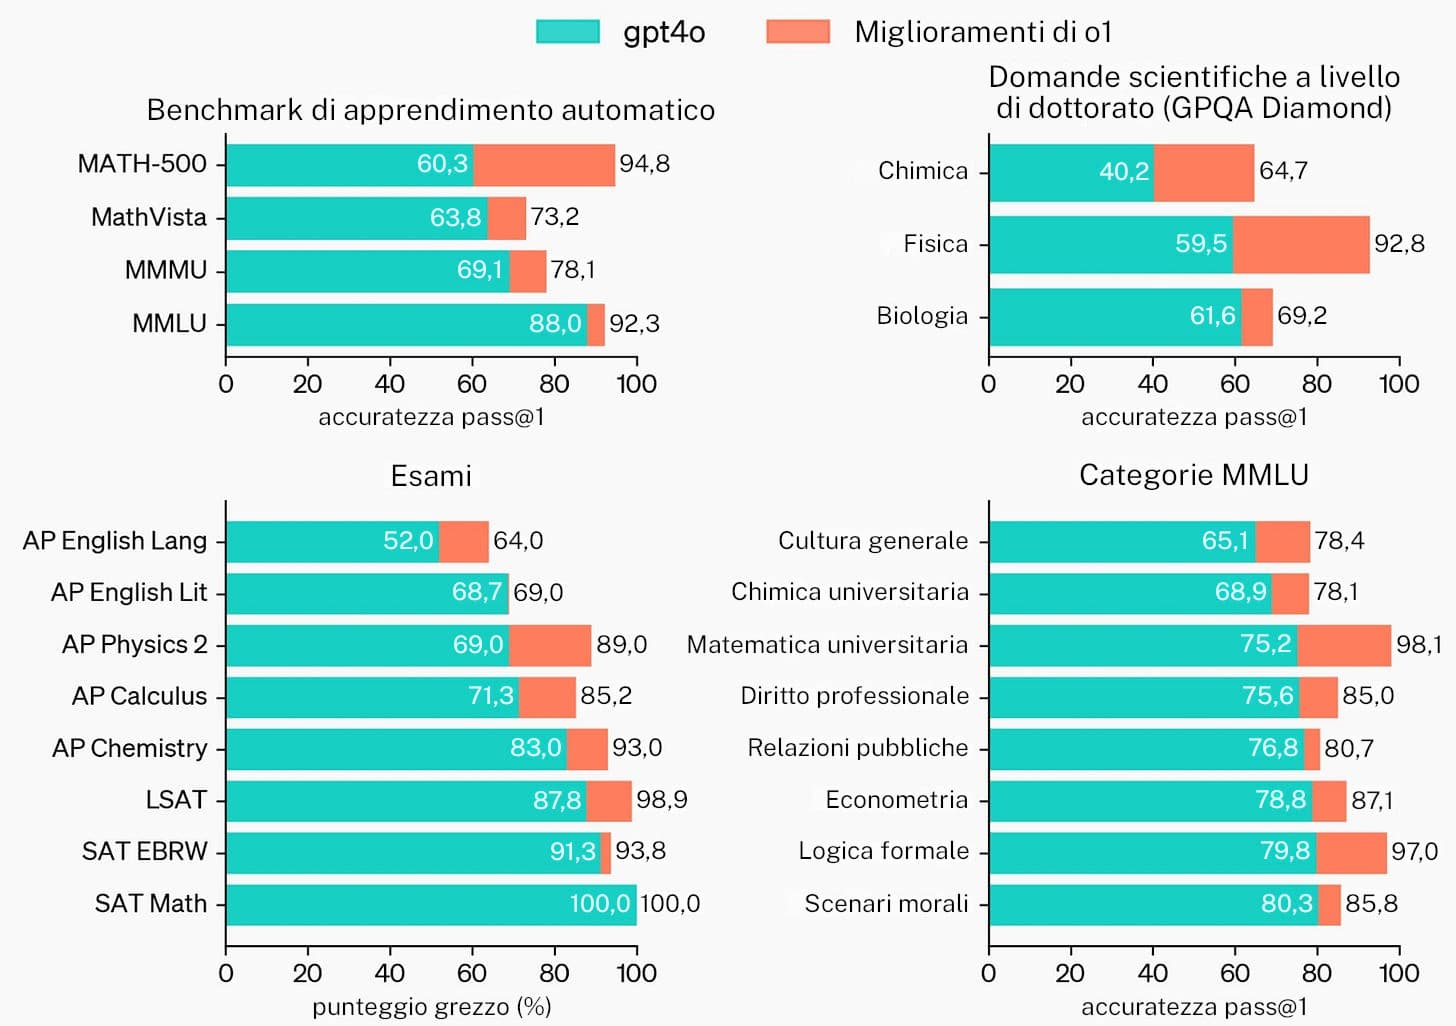
Ecco l’ampia batteria di test:
Inoltre, di recente alcune IA sono state dotate di una finestra di contesto da 100 milioni di token (il che significa che possono elaborare circa 750 romanzi per fornire una risposta).
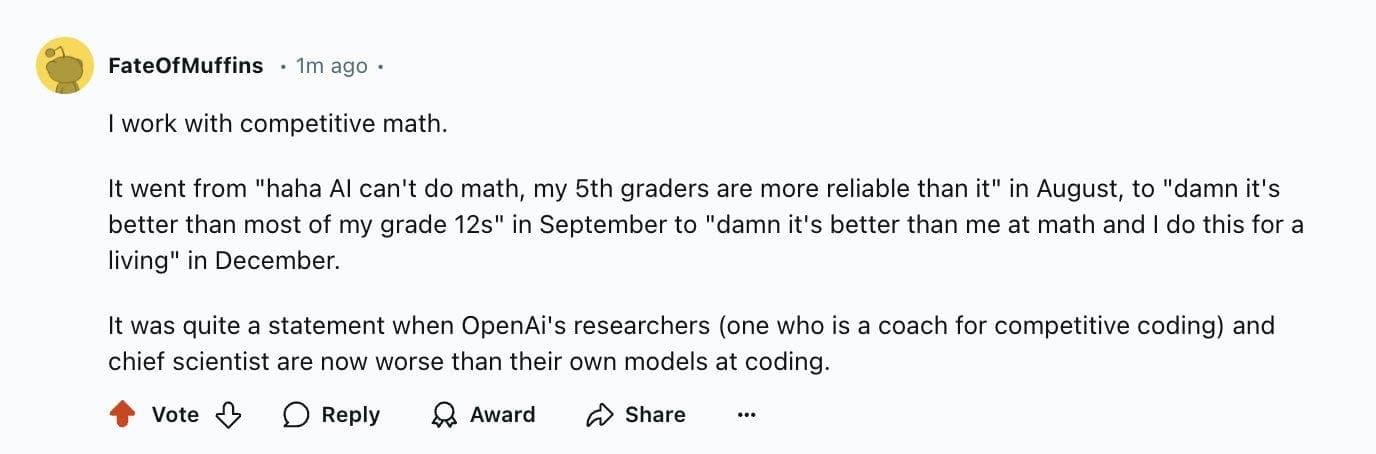
Tutto quello che vi ho appena detto riguarda o1, il modello precedente! Cosa sappiamo del modello attuale, o3, quello che OpenAI sta testando e di cui i ricercatori sono entusiasti?
Il GPQA è un difficile test scientifico progettato per i dottori di ricerca e impossibile da risolvere cercando su Google. I dottori di ricerca ottengono in media un punteggio del 34%. Nella loro area di specializzazione, raggiungono circa l’81%. Il nuovo modello di OpenAI, o3, ottiene l’88% di risposte corrette.
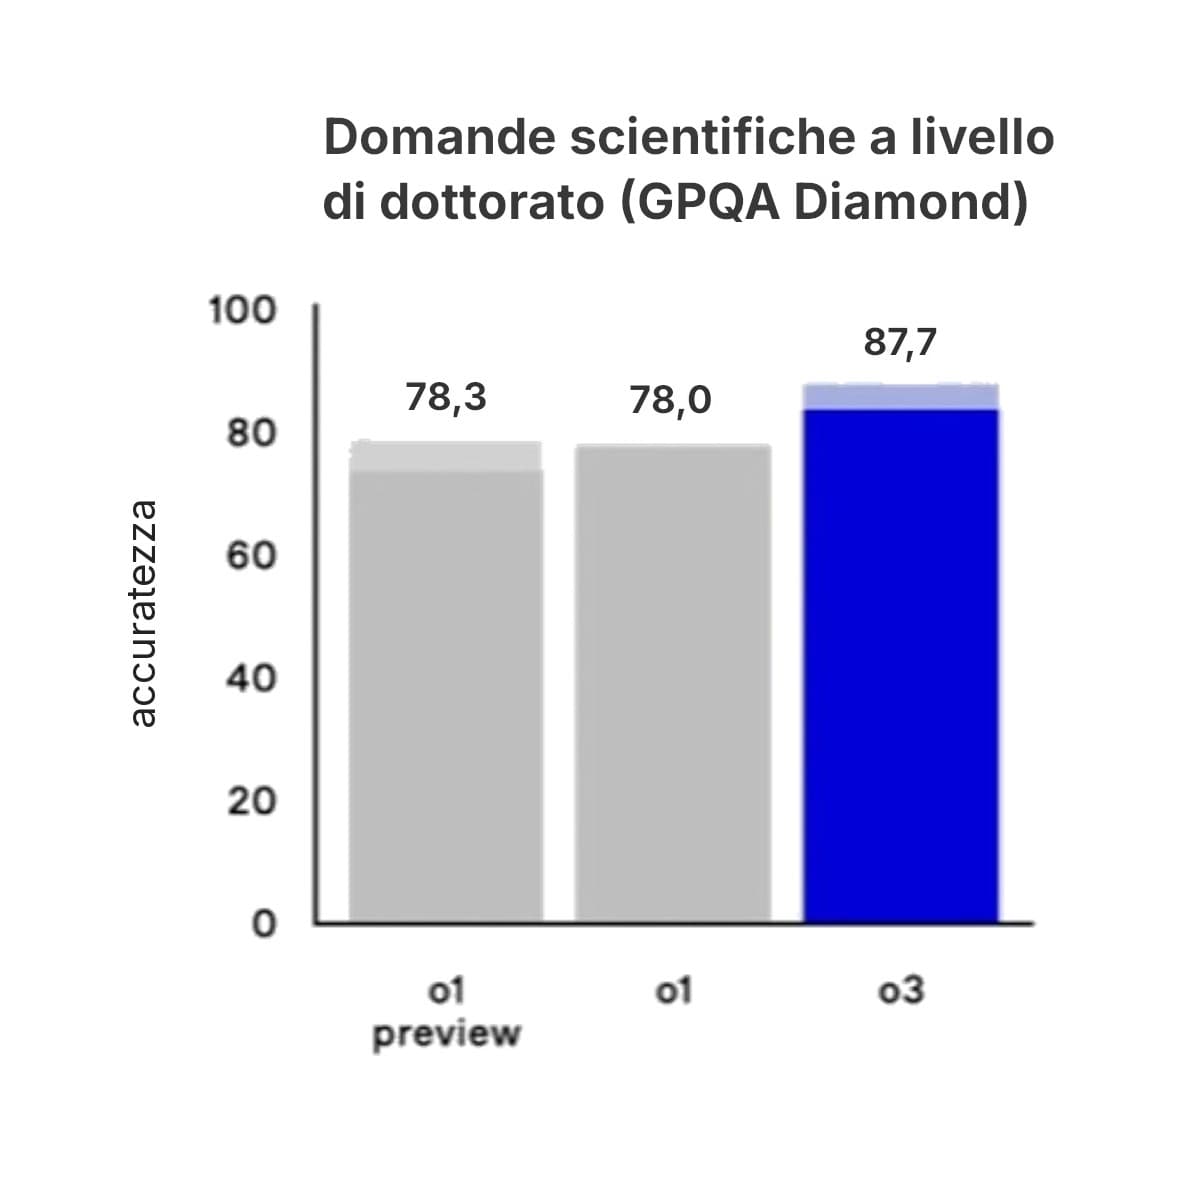
In altre parole, o3 è in grado di risolvere i problemi meglio degli esperti con dottorato nel loro campo.11
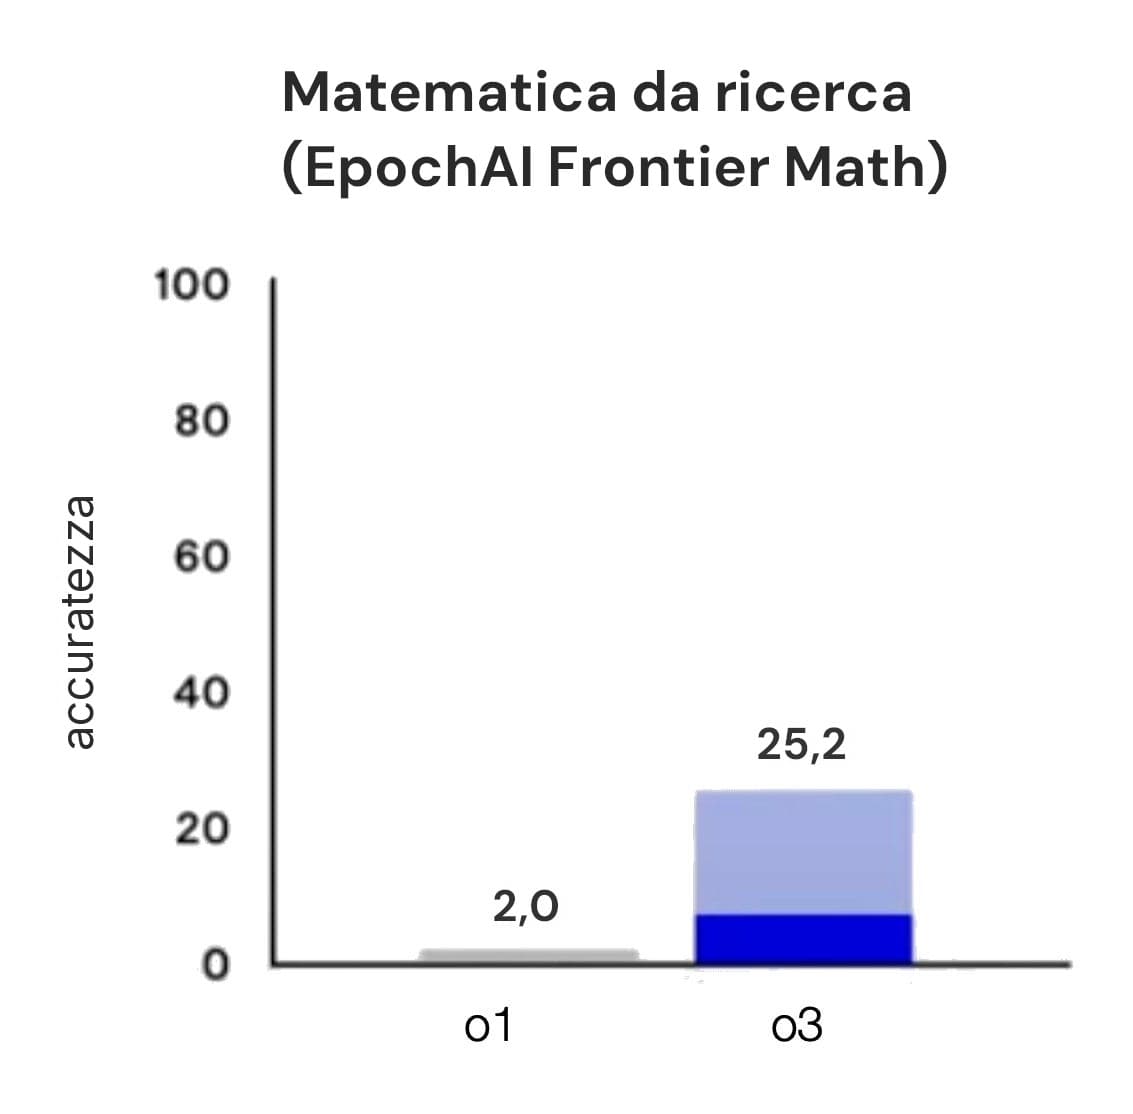
Un altro benchmark è FrontierMath, una raccolta di problemi matematici rigorosi e inediti, ideati da matematici per essere incredibilmente difficili da risolvere.
Si tratta di problemi davvero difficili… la maggior parte di essi sembra ben al di sopra delle mie capacità. — Evan Chen, allenatore delle Olimpiadi Internazionali di Matematica
Le IA non hanno mai ottenuto un punteggio superiore al 2%, ma o3 ha risposto correttamente al 25%.
ARC-AGI è un famoso test di intelligenza fluida, progettato per essere relativamente facile per gli esseri umani ma difficile per le IA. Mentre in media un essere umano ottiene il 75% e gli studenti post-laurea in discipline STEM arrivano al 100%, o3 ha battuto tutte le IA precedenti ottenendo l’87,5%.
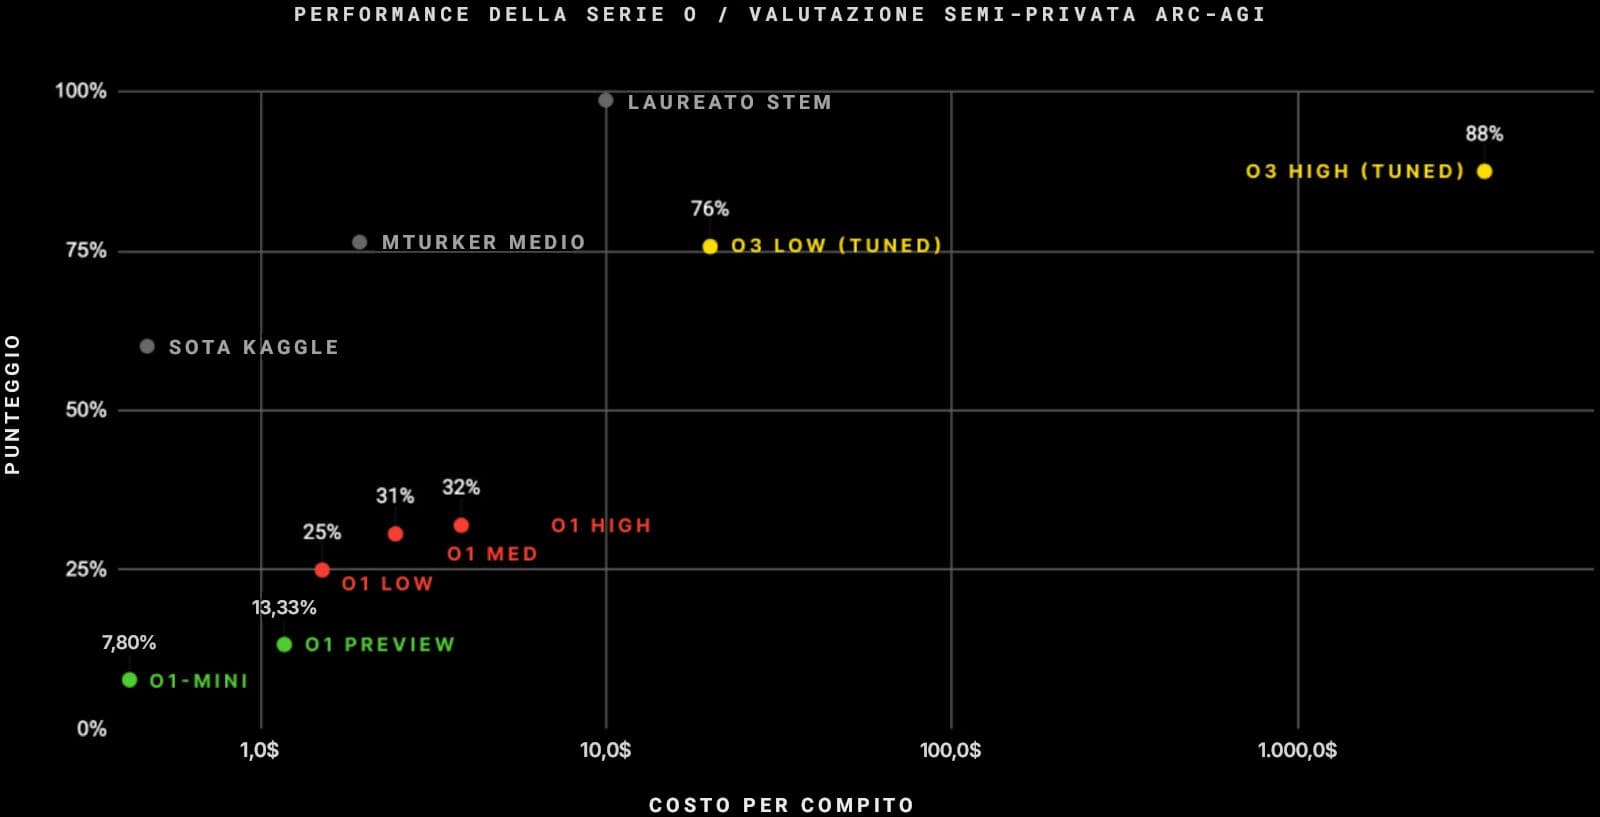
Un esperto di IA aveva previsto due anni fa (nel 2023) che ci sarebbero voluti altri 2-3 anni da oggi (quindi intorno al 2027-2028) perché l’IA superasse il 70% nell’ARC-AGI…
Lasciatemi riassumere:
-
Il modello o1 di OpenAI era talmente valido da appartenere già all’élite.
-
Il loro nuovo modello, o3, è talmente valido da superare gli esperti nei loro stessi campi.
-
Il progresso tra questi due modelli è stato questione di mesi.
-
I ricercatori di IA affermano che non è nemmeno ottimizzato!
-
Sono talmente sbalorditi da questo progresso che molti giungono alla conclusione che raggiungeremo l’IAG nel giro di 1-3 anni.
Siete già sbalorditi?
I limiti alla crescita
Ma forse stanno trascurando alcune barriere che potrebbero ostacolare questa crescita? Il progresso dell’intelligenza verso l’IAG può scontrarsi con un muro?
Forse la tecnologia ha qualche limite fondamentale riguardo ai tipi di problemi che è in grado di risolvere? No:
Abbiamo dimostrato matematicamente che i trasformatori possono risolvere qualsiasi problema, a patto che sia loro consentito di generare tutti i token di ragionamento intermedi necessari.—Denny Zhou, responsabile del team di ragionamento di Google DeepMind
Sembra quindi che la tecnologia e l’intelligenza non saranno i fattori limitanti per la SIA. Semmai, lo saranno le materie prime dell’IA. Queste sono:
- Dati, per addestrare i modelli di IA
- Potenza di calcolo (ovvero i chip), per addestrare ed eseguire i modelli
- Elettricità per alimentare i sistemi di calcolo
- Denaro per finanziare il resto.
- Qualità degli algoritmi, per ottimizzare tutto quanto sopra
Sembra che il punto (4), il denaro, non sarà un problema.
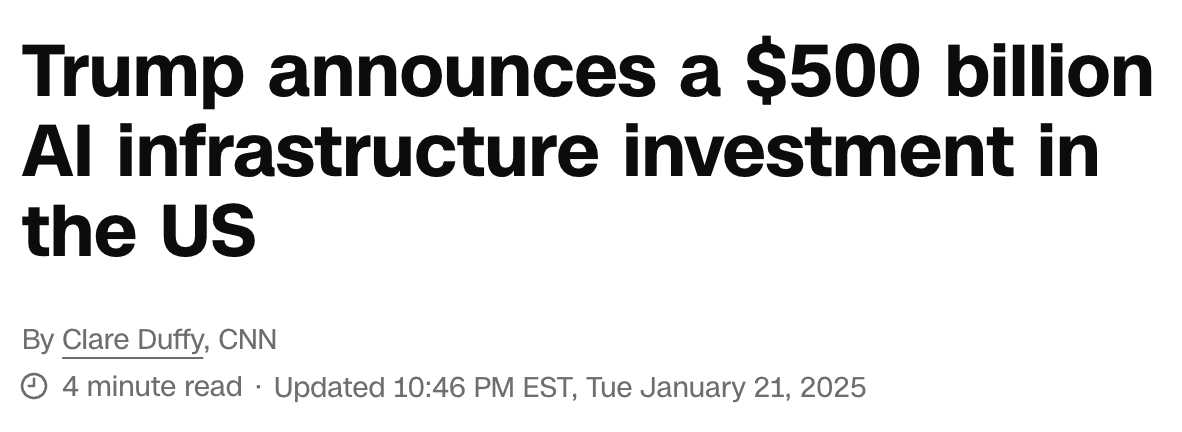
Gli occhi del mondo sono puntati sull’IA. Tutti sanno che è il futuro e sono disposti a investire i capitali necessari per renderlo realtà.
3. Elettricità
Aziende come OpenAI, Amazon, Meta e Google si stanno rendendo conto di quanta elettricità servirà loro e stanno investendo per creare una propria capacità di generazione, tanto che stanno tutte costruendo o riaprendo reattori nucleari, che forniscono elettricità stabile. Il loro prezzo più elevato rispetto ai combustibili fossili o alle energie rinnovabili non ha importanza per queste aziende, poiché l’elettricità rappresenta una quota dei costi molto inferiore rispetto alla potenza di calcolo.
Quanto sarà difficile produrre tutta l’elettricità di cui abbiamo bisogno? Prendiamo gli Stati Uniti come esempio più rilevante:
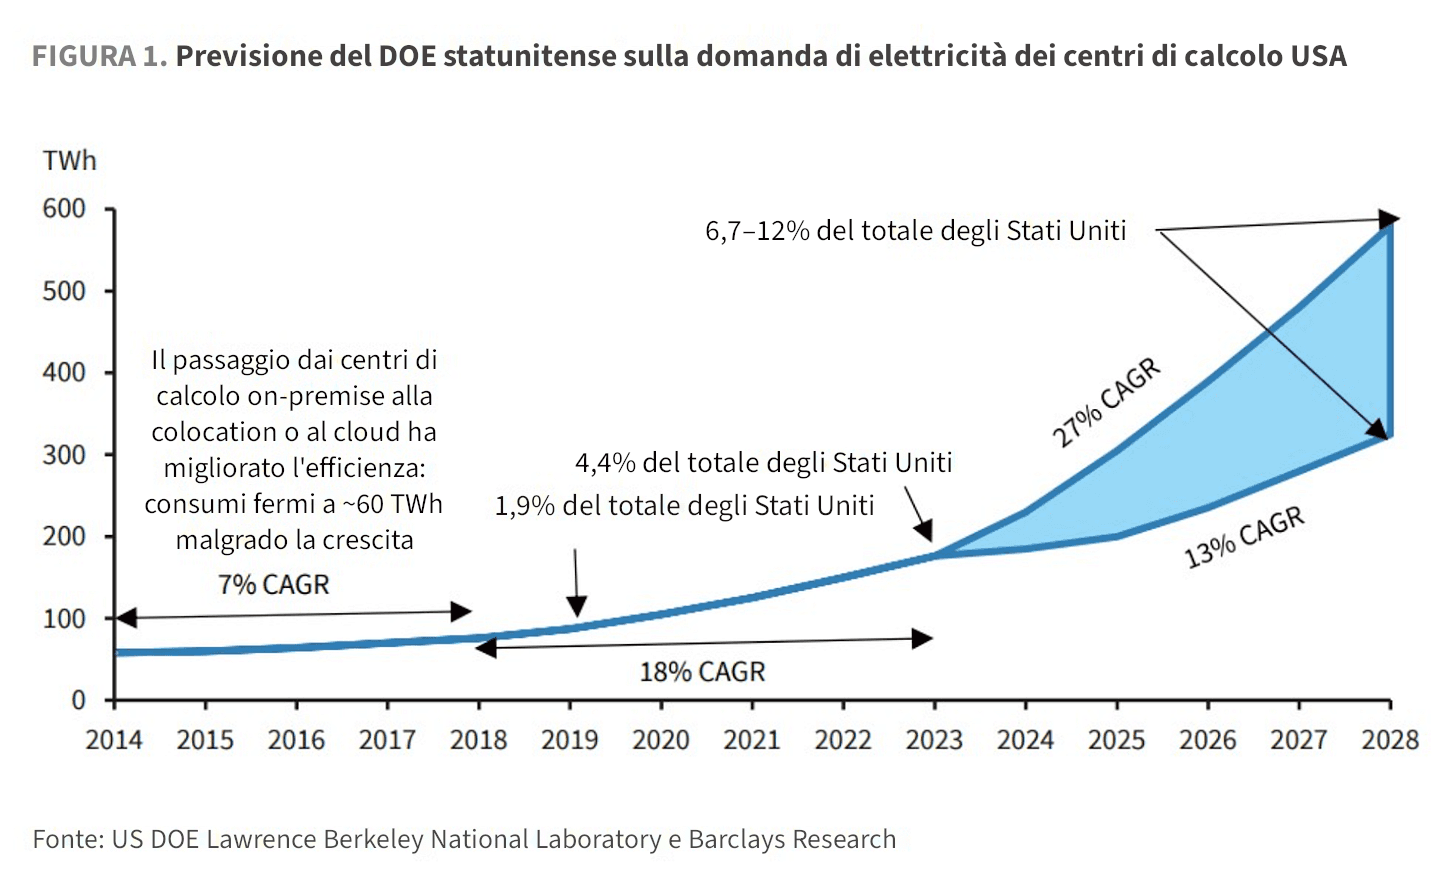
I centri di calcolo assorbono già il 4,5% della domanda di elettricità negli Stati Uniti, e tale percentuale salirà probabilmente al 7-12% entro quattro anni. Quanto sarà difficile? Beh, negli ultimi due decenni gli Stati Uniti non hanno aumentato di molto la propria produzione di energia elettrica, quindi potrebbe essere un obiettivo ambizioso.
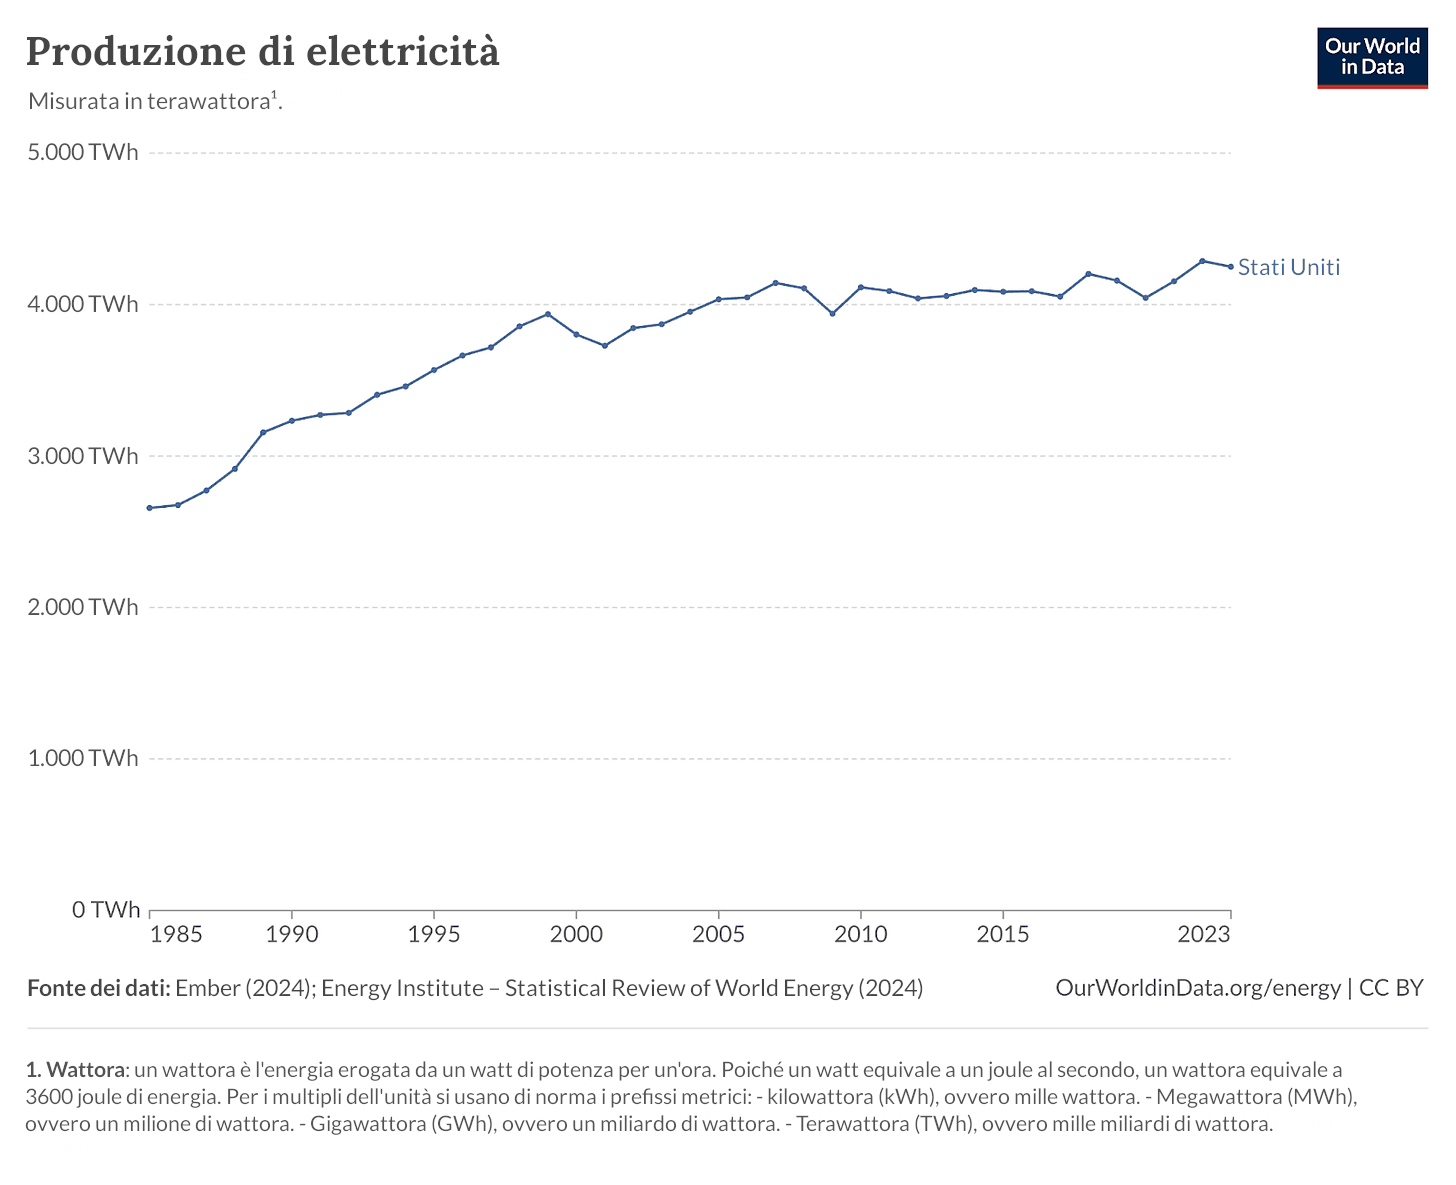
Ma le energie rinnovabili stanno esplodendo:
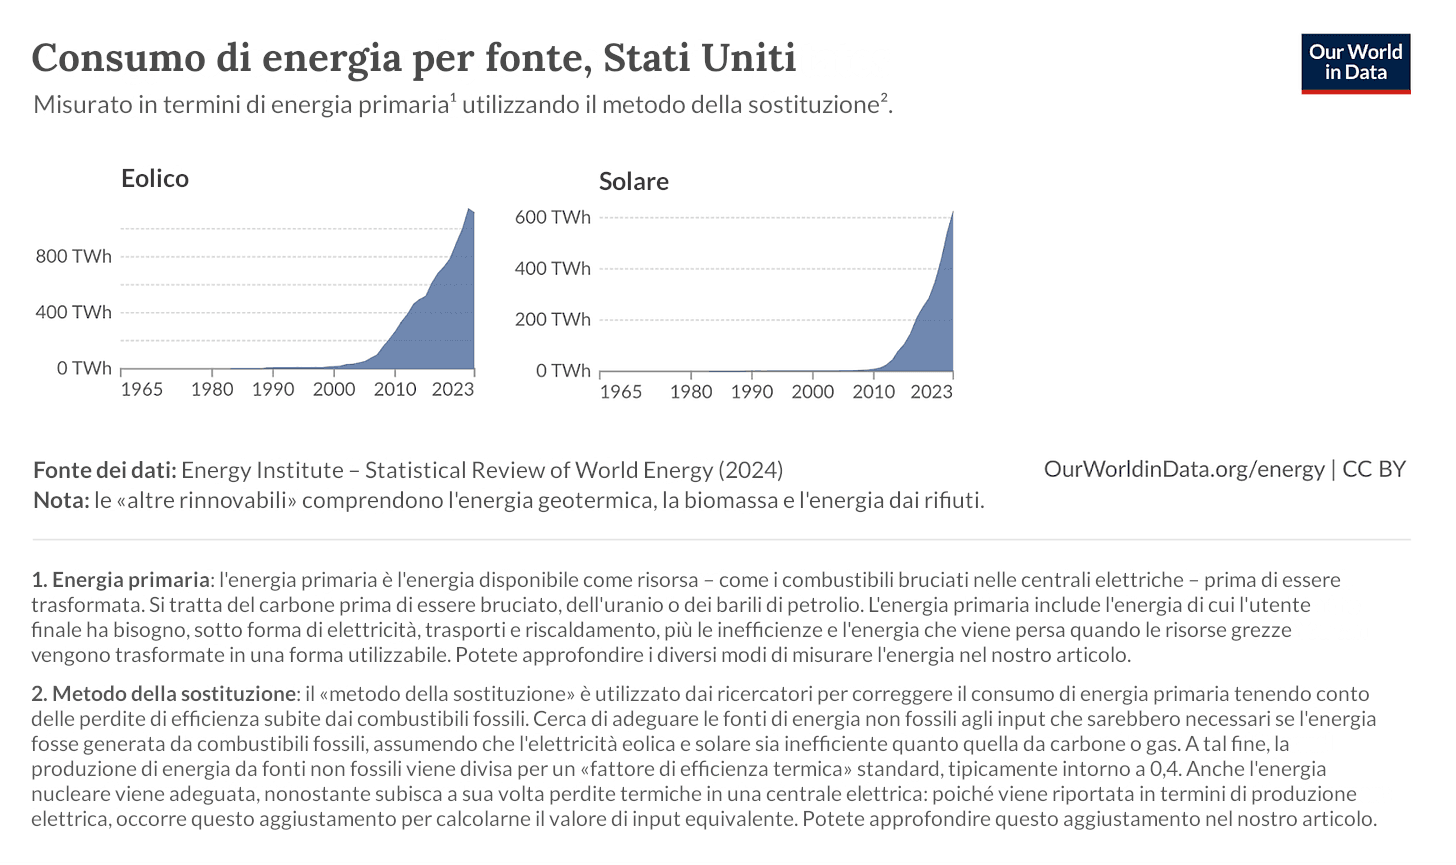
I centri di calcolo statunitensi avranno bisogno di circa 200 TWh di elettricità aggiuntiva entro il 2028, ma il solare e l’eolico stanno aggiungendo circa 200 TWh di elettricità all’anno, quindi non sono particolarmente preoccupato per l’elettricità.14
2. Potenza di calcolo
La potenza di calcolo sarà probabilmente il fattore limitante. Ecco perché NVIDIA è la terza azienda di maggior valore al mondo e perché altre due aziende produttrici di chip (Broadcom e TSMC) occupano il 10° e l’11° posto.
Ma la domanda è talmente alta che NVIDIA subisce una concorrenza sempre maggiore da parte di nuovi fornitori come Cerebras, AMD, Intel, le TPU di Google (con una domanda interna così elevata che Google consuma tutta la propria capacità e non le vende più), Microsoft, Groq…
1. Limiti dei dati
È vero che qui stiamo sbattendo contro un muro: abbiamo già dato in pasto a questi modelli quasi tutto Internet. La quantità di contenuti non digitalizzati ma facilmente recuperabili potrebbe raddoppiare i dati disponibili, ma niente di più. E allora? Ci sono due risposte a questo problema.
In primo luogo, i dati sintetici. Disponiamo già di motori fisici in grado di creare ambienti realistici in cui le IA possono muoversi. Ad esempio, possono contribuire ad addestrare le auto a guida autonoma. Una fonte di dati sintetici ancora più entusiasmante consiste semplicemente nell’usare l’IA per creare dati con cui addestrare altre IA. Perché funziona? Non vale forse il principio «spazzatura in ingresso – spazzatura in uscita»? No, perché in molti campi scientifici è facile creare esercizi, ottenere una risposta dalle IA e verificarne l’accuratezza. Se il risultato dell’esercizio generato dall’IA è corretto, all’IA viene comunicato. Se è sbagliato, le viene ugualmente segnalato, in modo che impari per la volta successiva.
In secondo luogo, il cervello umano non ha bisogno di consumare l’intero Internet per essere intelligente. Ciò significa che al momento stiamo decisamente esagerando: stiamo utilizzando migliaia di miliardi di token di dati perché i nostri algoritmi di addestramento e di calcolo dell’IA non sono ancora molto ottimizzati. La natura si è imbattuta nell’algoritmo del nostro cervello procedendo per tentativi ed errori. Noi possiamo almeno affrontare questo processo in modo efficiente.
In effetti, lo abbiamo appena fatto. Un’azienda cinese poco conosciuta ha rilasciato un’IA rivoluzionaria che sta spingendo tutti a ripensare il mondo dell’intelligenza artificiale.
DeepSeek: il momento «OMG» dei costi dell’IA
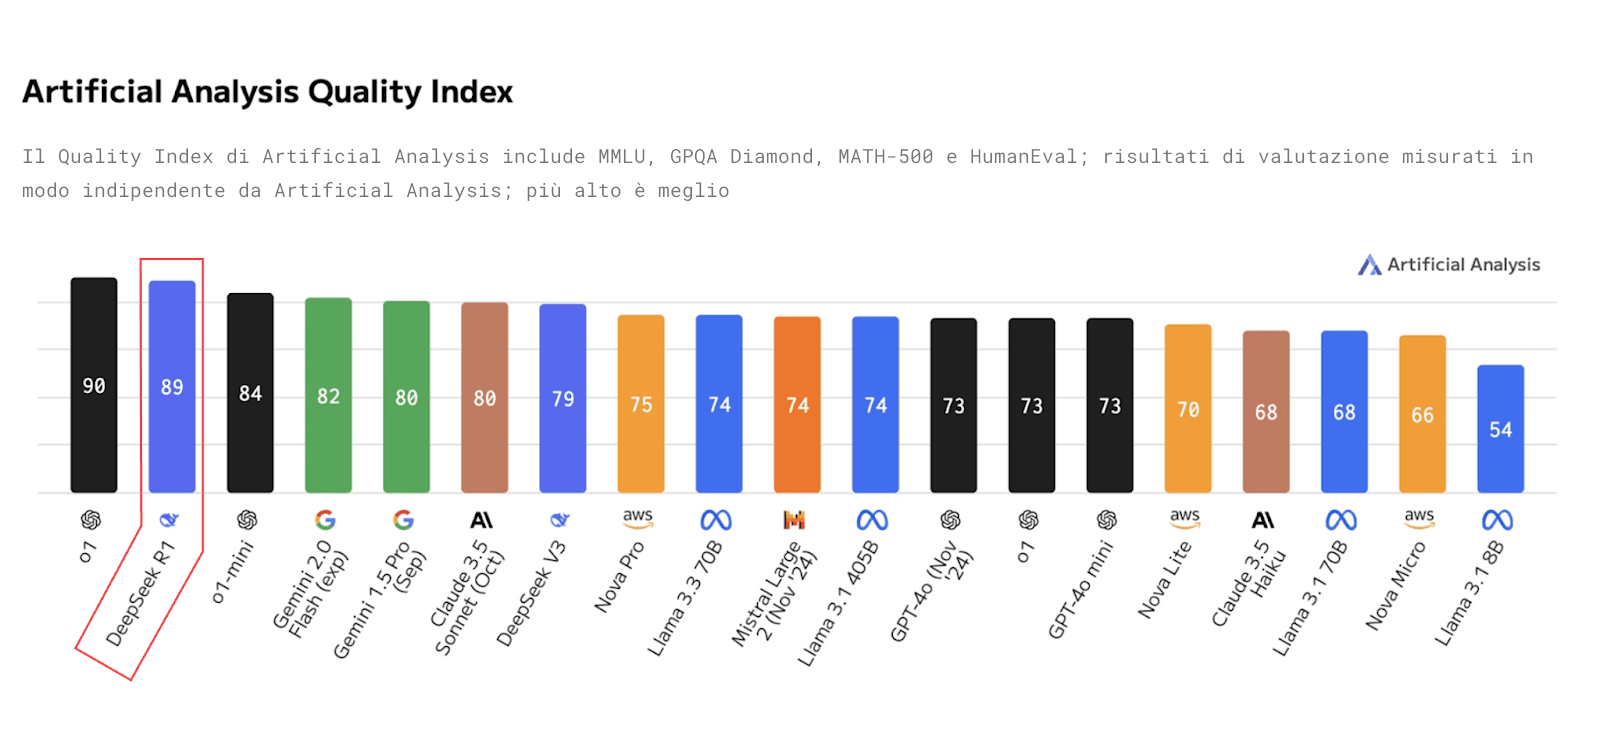
DeepSeek è una piccola organizzazione cinese che ha lanciato un nuovo modello di IA chiamato R1, che potete provare qui su desktop.15 Questo è il suo «punteggio di qualità dell’IA»:
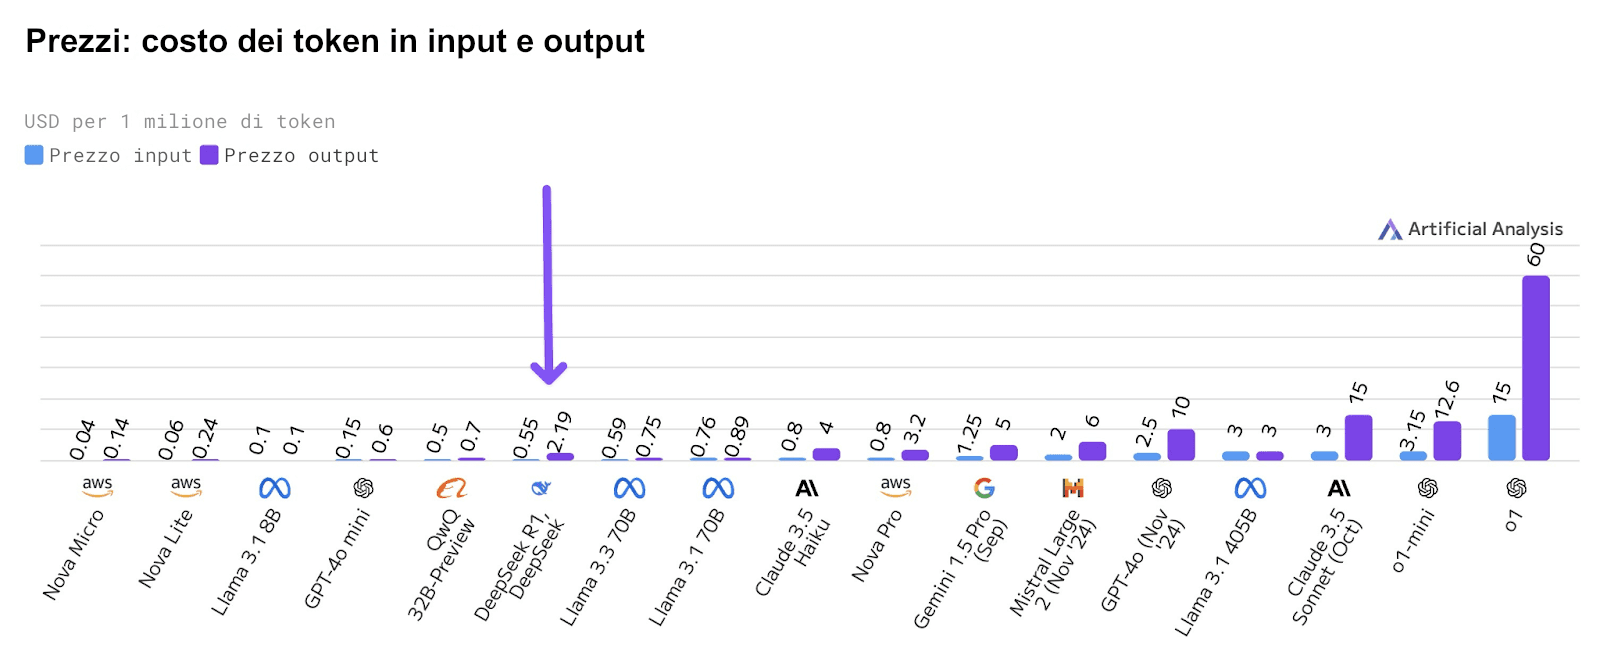
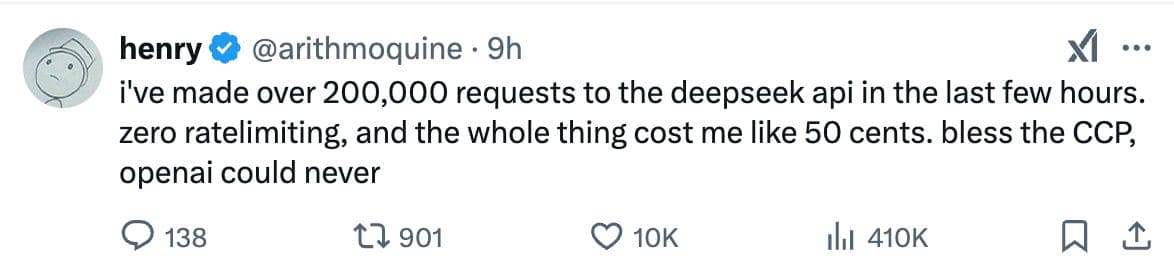
Costa 25 volte meno di o1:16
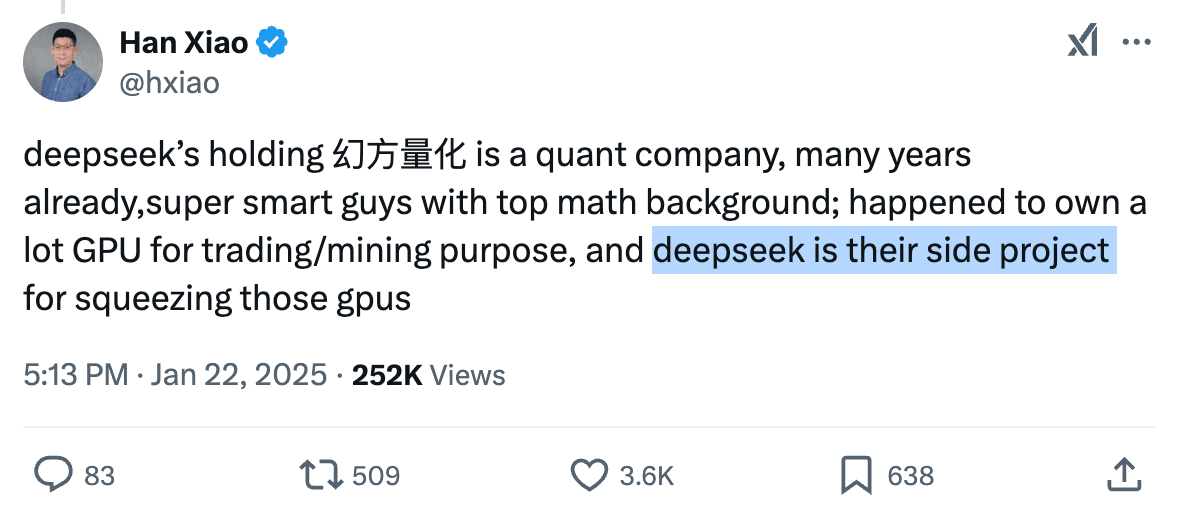
E chi c’è dietro tutto questo? Una startup cinese di 100 persone senza alcun finanziamento di venture capital.
Si tratta inoltre di un modello open source, il che significa che chiunque può esaminare il codice, contribuirvi e riutilizzarlo! Lo hanno regalato. Tutti gli strumenti che hanno impiegato per realizzare questa svolta sono ora a disposizione di tutti nel mondo.
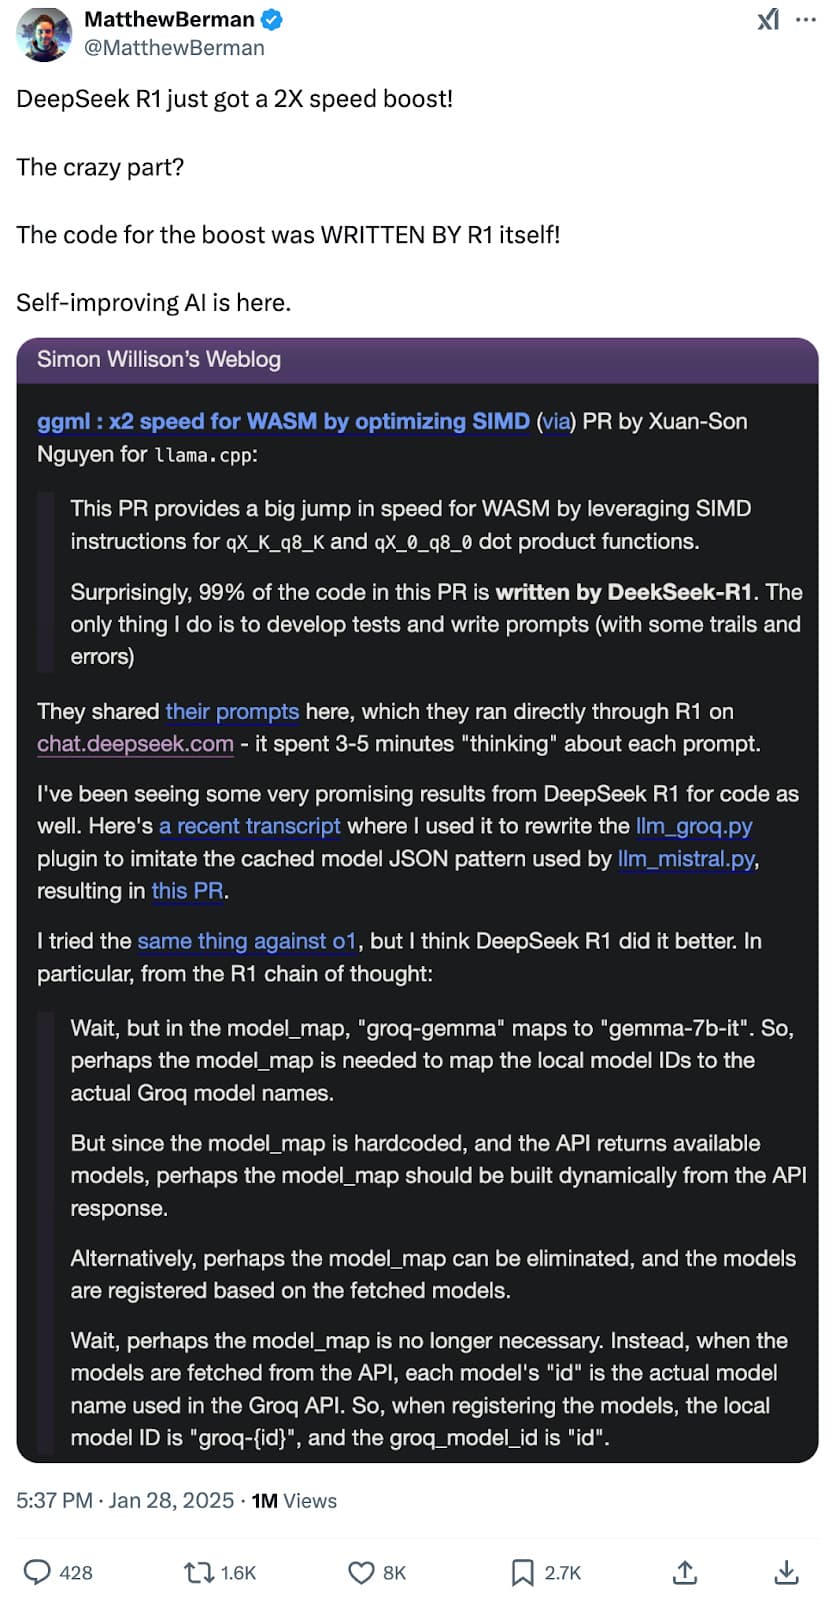
E DeepSeek si sta già migliorando da solo!
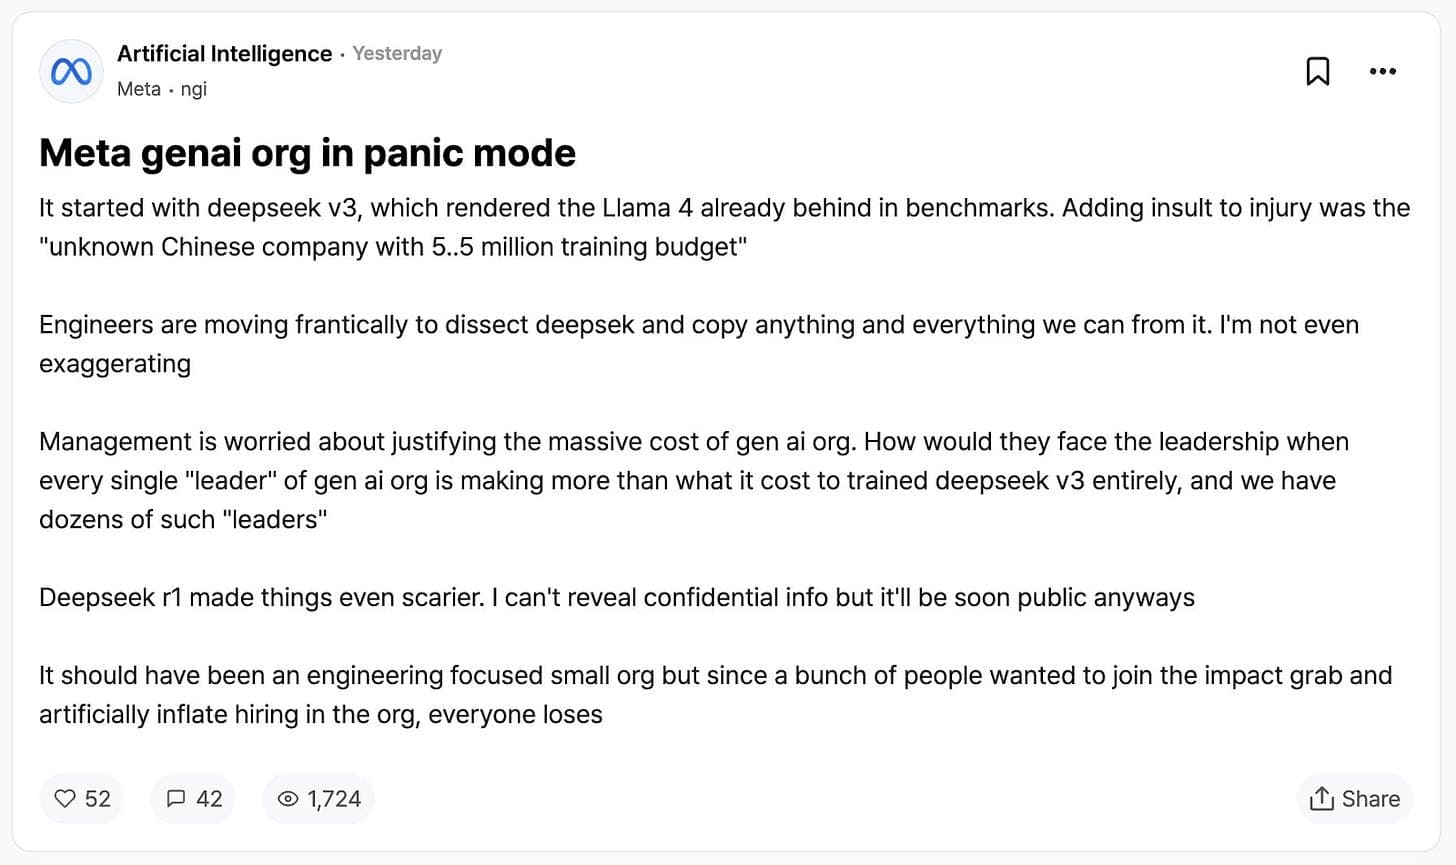
Come sta reagendo Meta (Facebook) a tutto questo? Meta ha iniziato a rilasciare versioni del proprio modello open source, Llama, due anni fa. Llama è peggiore di R1, e molto più costoso!
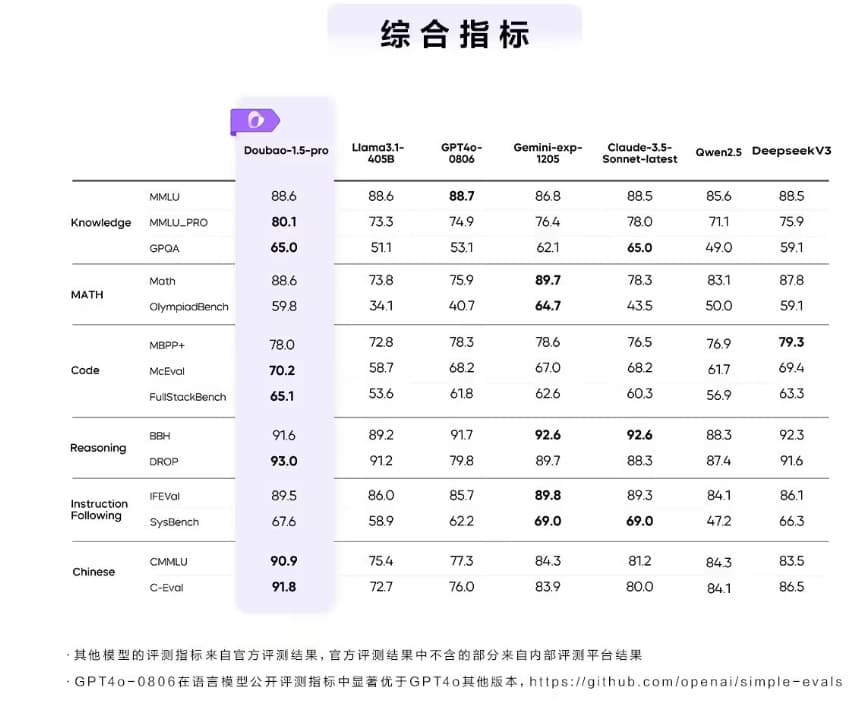
E DeepSeek non è l’unico a farlo. ByteDance Doubao-1.5-pro eguaglia o supera i benchmark di GPT 4o di OpenAI e di Claude Sonnet 3.5 di Anthropic ed è 50 volte più economico.
Ora, lasciate che vi dica: ho appena provato DeepSeek per la prima volta e la mia esperienza è stata profonda. Per la prima volta, mi sembra di avere un collaboratore capace per il tipo di ricerca che sto conducendo. Sono sbalordito.
Per anni mi sono chiesto perché un certo Paese sia così popoloso. L’avevo chiesto molte volte alle IA, ma mi hanno sempre deluso:
-
Non consideravano le cause profonde, come «C’è molta gente perché c’è stato un boom delle nascite.»
-
Confondevano i nessi causali, ad esempio dicendo cose del tipo: «C’è molta gente in questo paese perché la maggior parte delle persone vive in città, e le città sono molto densamente popolate».
-
Quando commettevo degli errori non se ne accorgevano, quindi non potevano mettere in discussione i miei presupposti.
-
Proponevano una serie di punti elenco, senza considerare le relazioni tra loro.
E hanno commesso molti altri errori.
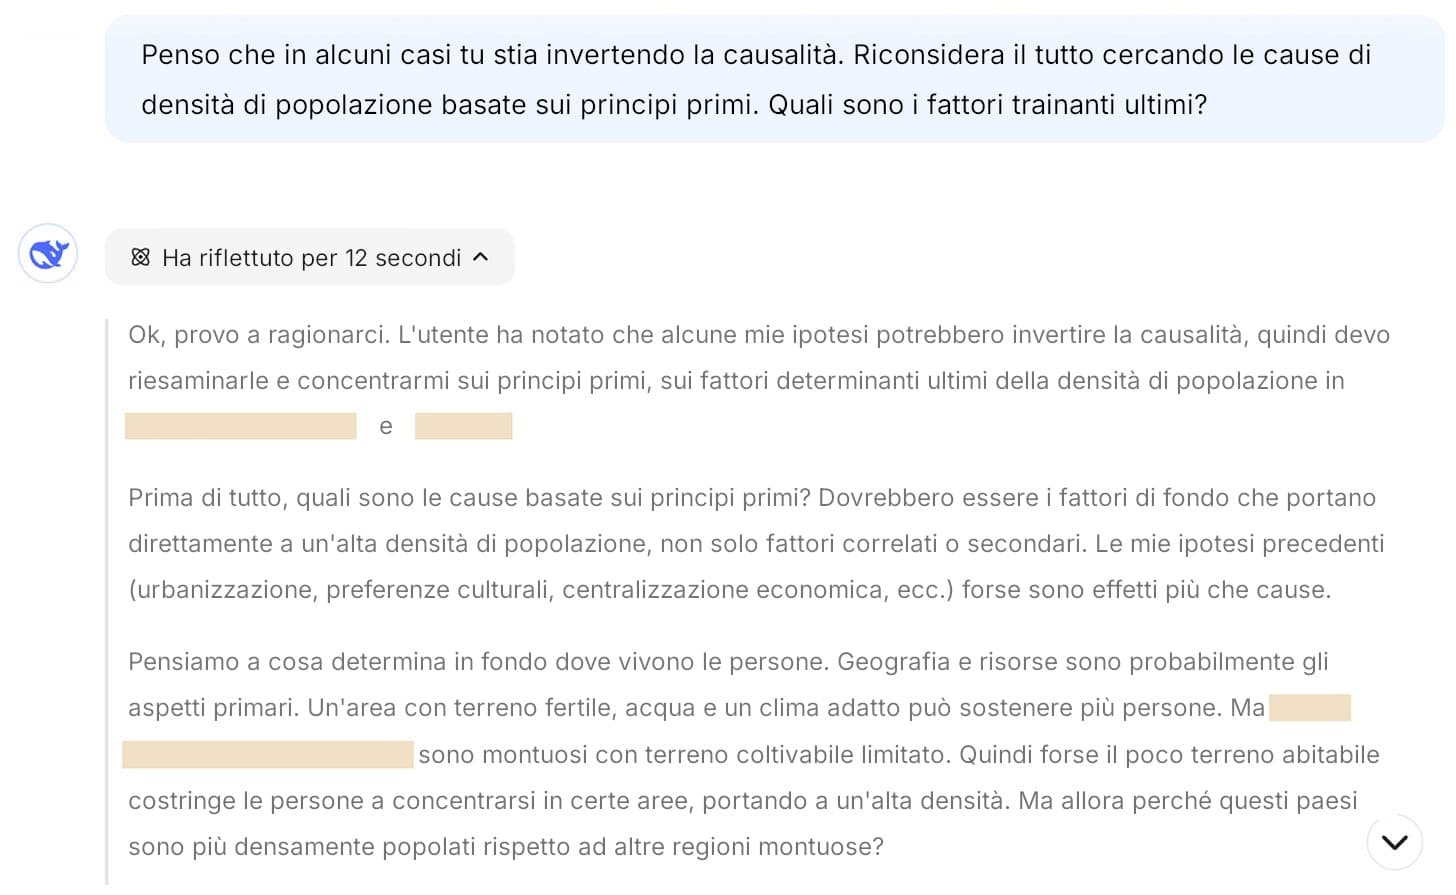
Con DeepSeek, per la prima volta un’IA è stata in grado di formulare in autonomia le mie stesse ipotesi, senza che fossi io a suggerirle. Per la prima volta, ha formulato ipotesi nuove. Ma è andata persino oltre: ha proposto procedure per testare le ipotesi, fornendo i dati e le fonti necessarie per eseguire le verifiche! E tutto questo in modo così rapido e gratuito! La cosa più sbalorditiva è stata che DeepSeek, se lo desideri, ti mostra il suo ragionamento, che si è rivelato impeccabile. Sembrava umano, come una persona molto intelligente e razionale. Tutti i dubbi sollevati dall’IA durante il suo ragionamento erano fondati, e mi hanno aiutato enormemente a migliorare i miei prompt. Ad esempio:
Come ha fatto DeepSeek a creare un modello così valido a un costo così basso? Non è chiaro, ma sembra trattarsi di una combinazione di fattori che spiegherò in un articolo premium, in cui tratterò anche i passi che ci separano dall’IAG.
L’aspetto rilevante qui è che non hanno richiesto alcun feedback umano! Hanno ideato un processo in cui si sono limitati a fornire dati alla macchina e a strutturare dei metodi affinché questa imparasse da sola. Ricordate quando vi ho detto in precedenza che i dati sintetici avrebbero svincolato il progresso dell’IA dai limiti imposti dai dati? Questo ne è un esempio perfetto.
Questo è molto importante perché, in passato, il più grande collo di bottiglia per il progresso dell’IA sono sempre stati gli esseri umani. AlphaGo ha dovuto imparare da decine di milioni di mosse umane prima di poter battere l’uomo, e quel processo ha richiesto mesi. AlphaGo Zero, invece, ha imparato a battere l’uomo senza alcun input umano, giocando contro sé stesso, in soli 3 giorni.
AlphaGo Zero ha battuto AlphaGo 100 a 0.
Cosa significa tutto questo? È ora di mettere insieme tutti i pezzi.
Conclusioni: il futuro sta per abbattersi su di noi
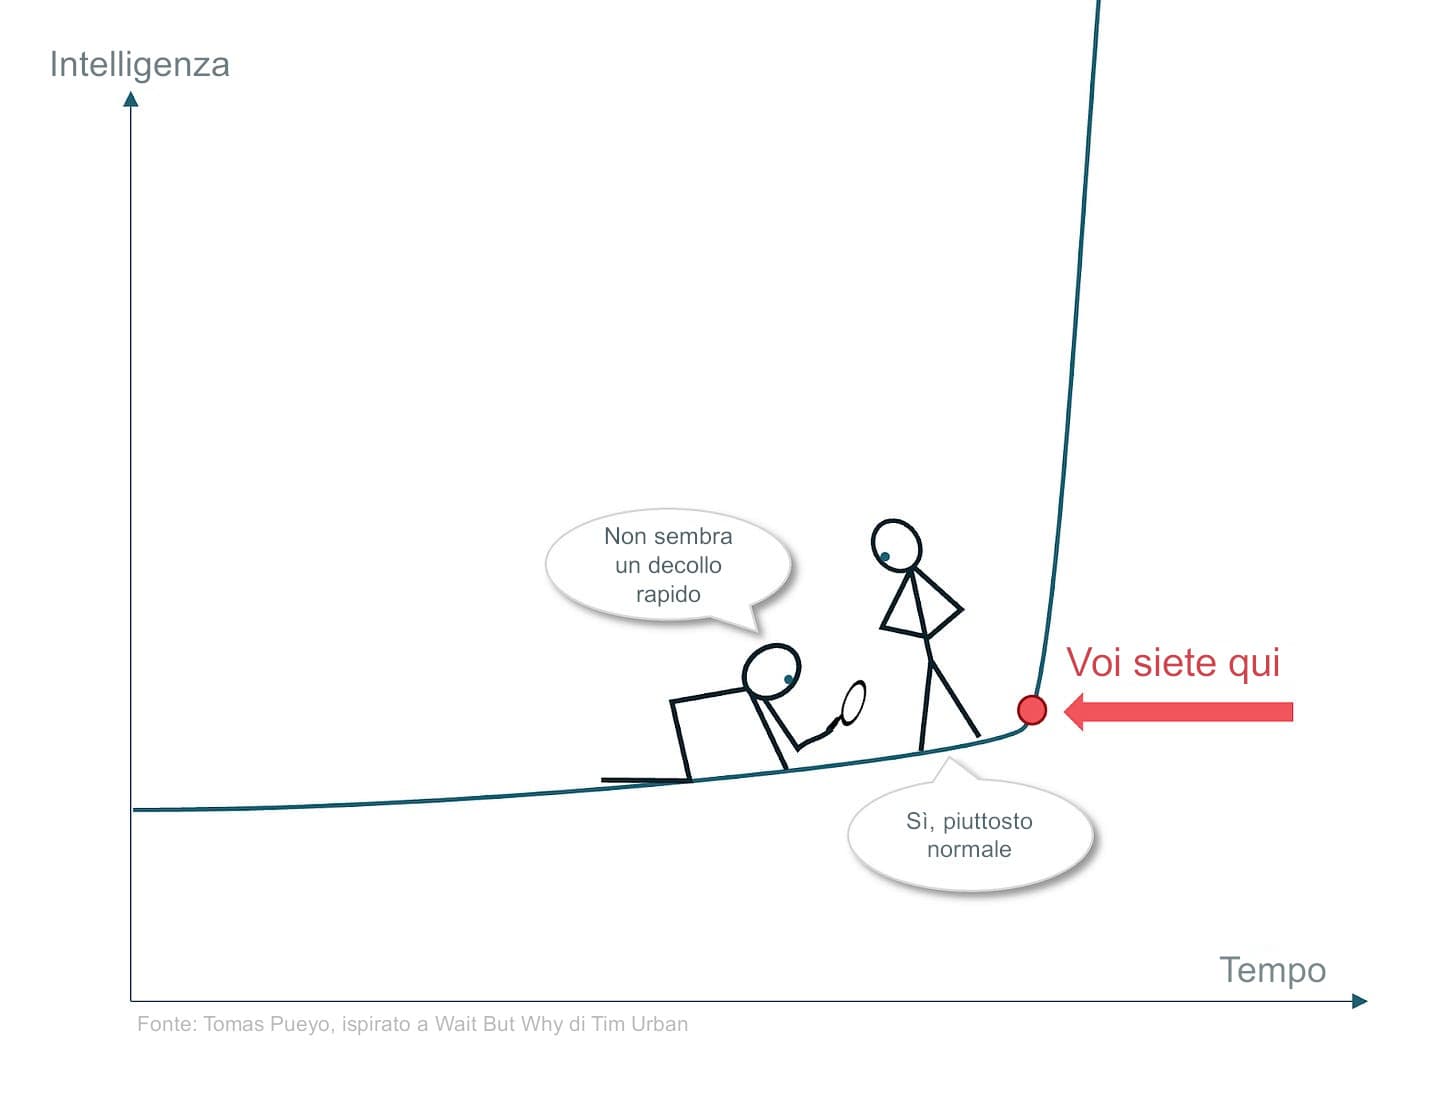
-
I migliori modelli di IA erano intelligenti all’incirca quanto topi quattro anni fa, cani tre anni fa, studenti delle superiori due anni fa, studenti universitari medi un anno fa, dottori di ricerca qualche mese fa, e ora sono migliori dei dottori di ricerca umani nel loro stesso campo. Basta proiettare tutto questo nel futuro.
-
I creatori di questi modelli affermano tutti che le prestazioni stanno scalando più rapidamente del previsto, senza l’impiego di strani trucchi. Anzi, vedono opportunità di ottimizzazione ovunque. L’intelligenza semplicemente scala. Ritengono che l’IAG sia distante 1-4 anni. Si tratta di una visione solo leggermente più ottimistica rispetto ai mercati, che ne stimano l’arrivo tra circa 2-6 anni.
Le IA sono ormai come sviluppatori di software d’élite. E l’IA sta già migliorando l’IA. Unendo le due cose, si può immaginare quanto rapidamente accelererà la velocità di sviluppo dell’IA.
A questo punto, non sembra che l’intelligenza rappresenterà un ostacolo per l’IAG. Piuttosto, potrebbero esserlo altri fattori, come l’energia o la potenza di calcolo.
Solo che DeepSeek ha appena dimostrato che possiamo realizzare modelli che consumano ordini di grandezza in meno di denaro, energia e potenza di calcolo.
Quindi, sebbene l’elettricità, i dati e soprattutto la potenza di calcolo possano essere fattori limitanti per la crescita dell’IA, troviamo costantemente il modo di rendere questi modelli più efficienti, eliminando tali vincoli fisici.
In altre parole: l’IA sta progredendo sempre più velocemente, non abbiamo barriere evidenti che ne ostacolino l’avanzata e gli addetti ai lavori ritengono che ciò significhi che vedremo l’IAG nel giro di mezzo decennio.
Per rispondere alle domande che ho posto nell’introduzione: in questo momento ci stiamo lanciando dal precipizio e, con ogni probabilità, ci vorranno alcuni anni (da 1 a 6, a seconda di chi si interpella) per imparare a volare o per schiantarci al suolo.
Come possiamo prepararci a quel momento? È ciò che intendo esplorare nei prossimi articoli:
-
Quali sono le ultime novità in merito all’impatto su specifiche professioni?
-
L’IA accelererà la scienza?
-
Cosa abbiamo imparato sull’allineamento? Le IA ci uccideranno?
-
Come puoi tu avvicinarti all’IA, se non ne sai nulla? Come puoi tu cavalcare l’onda?
Approfondirò queste idee nei prossimi articoli!