Dibattiti ancora irrisolti sul futuro dell’IA
Fino a che punto può spingersi il paradigma attuale, l’IA che migliora l’IA, e se continuerà ad avere senso considerare l’IA come uno strumento
Il post di oggi è la trascrizione, leggermente modificata, di un intervento che ho tenuto qualche settimana fa alla Conferenza sulle innovazioni tecniche per le politiche sull’IA organizzata da FAR.AI. Il video (21 min) è disponibile a questo link; gli altri interventi della conferenza si trovano sul canale YouTube degli organizzatori.
Trascrizione dell’intervento e diapositive
Il problema che mi ha spinta a tenere questo intervento oggi era ricorrente.
Un primo esempio risale al 2022, quando, a breve distanza l’uno dall’altro, sono apparsi titoli su come l’apprendimento profondo fosse arrivato a un punto morto e, subito dopo, su come ChatGPT stesse lanciando una rivoluzione completamente nuova.
L’anno scorso, il Wall Street Journal ha pubblicato un reportage — davvero ben fatto — sulle reali sfide interne a OpenAI nello scalare i propri modelli pre-addestrati, su quanto fosse difficile e su come non fossero soddisfatti dei risultati; poi, letteralmente il giorno stesso, è stato rilasciato o3, la nuova generazione del loro modello di ragionamento, e François Chollet — noto per il suo scetticismo — ha affermato che si trattava di una svolta significativa nel suo benchmark ARC-AGI. Punti di vista molto contraddittori, entrambi con un fondo di verità.
Poi, il mese scorso, sono uscite due importanti pubblicazioni che immagino molti dei presenti abbiano visto. Una sostiene che l’IA sia semplicemente una tecnologia normale e che seguirà lo stesso percorso visto in molte tecnologie precedenti; l’altra descrive come potremmo avere un’IAG entro il 2027, una superintelligenza entro il 2030 e un mondo trasformato in modo assolutamente radicale. Ancora una volta, prospettive molto diverse, entrambe con un fondo di verità.
Quindi, in sostanza, questo intervento è per chiunque… alzate la mano se siete mai stati personalmente vittime del bombardamento di notizie sull’IA e di quanto siano contraddittorie. Sì, questo intervento fa per voi. Se non avete alzato la mano potete uscire, non mi offendo, va bene così.
Un amico ha visto il titolo dell’intervento e ha detto: «Aspetta, come hai fatto a farti concedere uno spazio di nove ore per trattare tutti i dibattiti irrisolti?». Ma parleremo solo di tre dibattiti. Ci concentreremo sui dibattiti tecnici, ovvero su come l’IA si evolverà in quanto tecnologia, e non su cosa faremo al riguardo o su come influenzerà la società. E sui dibattiti che, a mio avviso, sono i più rilevanti o che, secondo me, rappresentano un modo utile per analizzare alcune delle divergenze.
In altre parole, non parleremo delle tempistiche per l’IAG, né di p(catastrofe), perché ritengo che nessuno di questi due argomenti sia altrettanto produttivo.
Ecco i tre dibattiti di cui voglio parlare: fino a che punto può spingersi il paradigma attuale? Quanto può l’IA migliorare l’IA? E le future IA saranno ancora fondamentalmente strumenti, o saranno qualcos’altro?
#1: Fino a che punto può spingersi il paradigma attuale?
Spesso si sente dire: «La scala è tutto ciò che serve?» oppure «È possibile scalare i modelli linguistici fino a raggiungere l’IAG?» Non credo che questa sia una domanda particolarmente utile, o forse la ritengo un po’ fuorviante. Preferirei piuttosto chiedere: ci troviamo su un ramo valido dell’albero tecnologico?
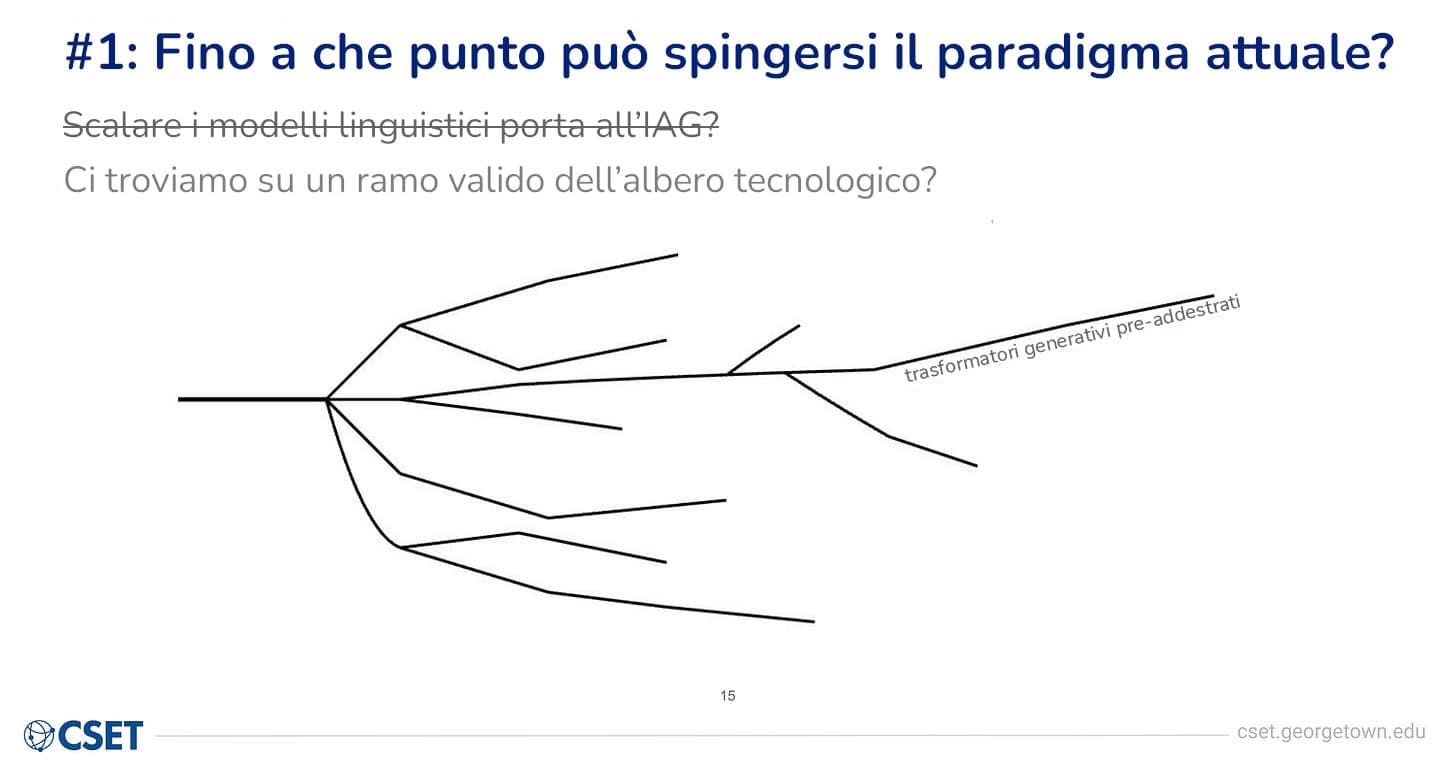
Se immaginiamo di esplorare questo albero di potenziali tecnologie da sviluppare, e di aver esplorato alcuni percorsi più a fondo rispetto ad altri, allora quello attuale su cui ci troviamo — potete chiamarlo in vari modi, ma io lo chiamerò il ramo dell’albero dei «trasformatori generativi pre-addestrati» (GPT, dall’inglese “generative pre-trained transformers”).
Il motivo per cui lo trovo più utile è che non è proprio vero che abbiamo preso il GPT-1 del 2018, o giù di lì, e lo abbiamo semplicemente scalato. Al contrario, abbiamo continuato ad aggiungere diverse modifiche architetturali, diversi modi di raccogliere ed elaborare i dati; ora ci occupiamo di ragionamento, ora sviluppiamo agenti — ma tutto questo prosegue lungo lo stesso ramo dell’albero, o lungo rami simili.
Quindi, per quanto riguarda questo dibattito — fino a che punto può spingersi l’attuale paradigma? — se può spingersi molto lontano, ciò significa che possiamo continuare su questo ramo dell’albero su cui ci troviamo e che esso continuerà a dare frutti, per così dire, mescolando un po’ le metafore. Contro, forse dobbiamo tornare indietro e imboccare un ramo un po’ diverso dell’albero tecnologico, o forse dobbiamo fare molti passi indietro e magari non occuparci nemmeno di apprendimento profondo o dedicarci a qualcosa di molto diverso dai modelli linguistici.
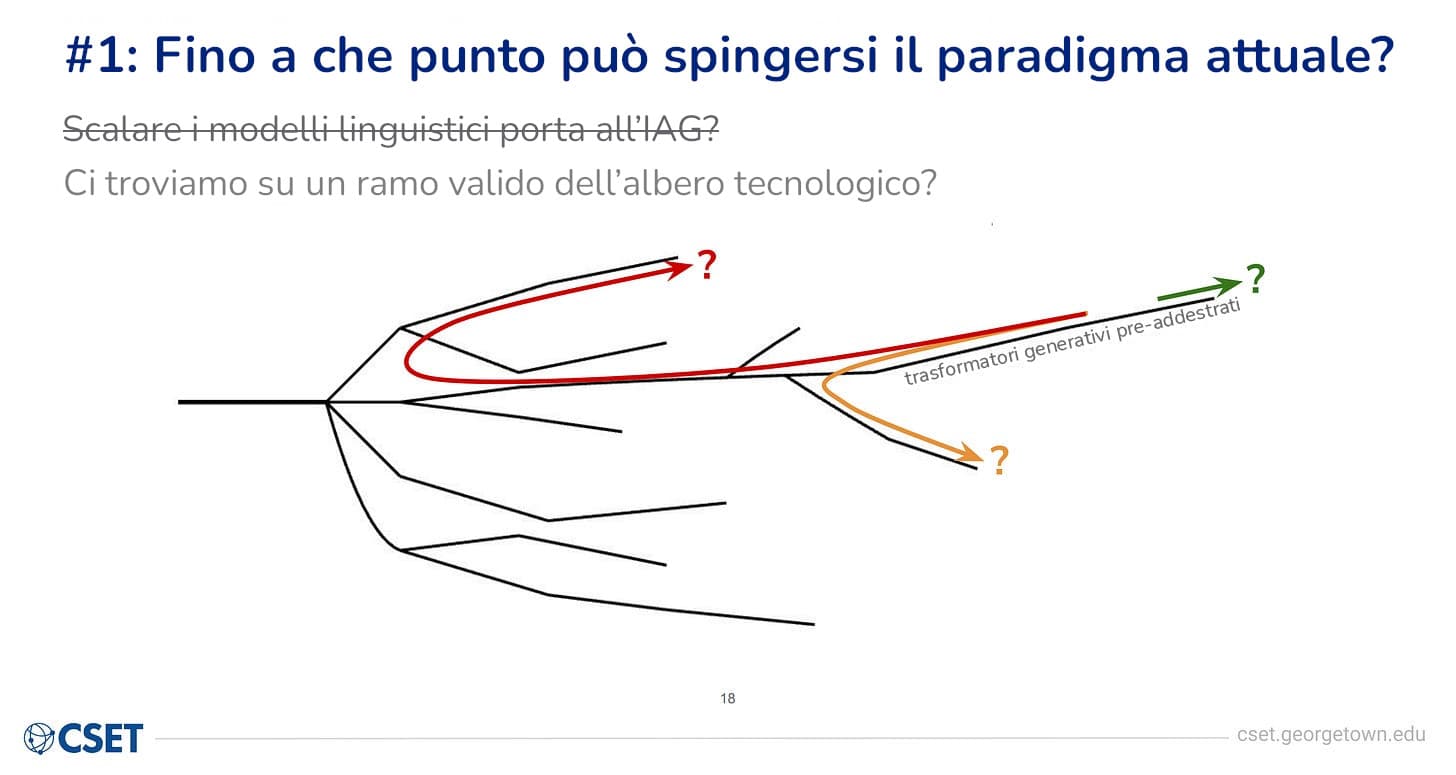
Esistono diverse argomentazioni sulla possibilità di spingersi lontano o meno.
Argomentazioni a favore di «abbastanza lontano»:
-
Miglioramenti di piccola e media entità. Un punto davvero importante consiste semplicemente nel riconoscere che tutti i progressi a cui abbiamo assistito negli ultimi 10-15 anni non sono derivati da grandi cambiamenti di paradigma o da grandi scoperte, ma piuttosto da questi diversi miglioramenti di piccola e media entità. Ripensando al 2015-2016, quando si è iniziato a far funzionare l’apprendimento per rinforzo nei giochi, a capire come combinarlo con la ricerca ad albero e a superare le prestazioni umane nel Go; il trasformatore, che ha avuto un’enorme importanza, è stato presentato nel 2017 — la base di tutti i nostri attuali modelli linguistici — ed è stato un grande miglioramento, ma non tale da stravolgere il paradigma rispetto alle RMBLT (reti a memoria a breve e lungo termine); c’è una lunga storia di questi miglioramenti di piccola e media entità, quindi potremmo continuare a vedere molti progressi in questo senso.
-
Trovare nuove cose che si possano scalare. Spesso, parlando di scala, ci si chiede: «Dobbiamo semplicemente scalare ciò che abbiamo?». Ma se si parla con chi lavora all’interno delle aziende di IA che se ne occupano, con chi fa ricerca, si scopre che non pensano semplicemente ad alzare la manopola della scala. Al contrario, considerano una parte importante del loro lavoro l’individuazione di elementi che si possono scalare, individuando aspetti in cui se si aumenta la scala, si ottengono buoni rendimenti. E se si parla con le persone all’interno di quei team di ricerca in questo momento, ritengono di avere parecchi nuovi elementi che possono continuare a scalare e di cui siamo solo agli inizi. Cose come l’addestramento al ragionamento, la multimodalità come nuova fonte di dati, la ricerca di modi per addestrare le capacità agentiche su larga scala. Abbiamo bisogno di elementi per cui sia possibile aumentare la scala e ottenere buoni risultati, e sembra che al momento ne abbiamo alcuni ancora in una fase iniziale.
-
Adozione —> volano di dati. Un altro aspetto da tenere d’occhio: per le aziende e i team di ricerca che si occupano di questo, i dati sono molto preziosi, e un ottimo modo per ottenerli è un’adozione nel mondo reale che si possa poi utilizzare per addestrare i sistemi futuri. Quindi, man mano che i modelli linguistici e le tecnologie del ramo GPT dell’albero iniziano a diventare utili e a essere adottati, ciò significa che otterremo un maggiore effetto volano, un maggiore rinforzo.
Ci sono anche ragioni per ritenere che l’attuale paradigma non ci porterà molto lontano o non si spingerà ancora molto oltre.
Argomenti a favore del «non molto lontano»:
-
Questioni intrattabili. Esistono alcune questioni davvero importanti che hanno ripetutamente causato problemi ai GPT e che sono ancora irrisolte oggi. Tra queste vi sono le allucinazioni, note anche come confabulazioni — ovvero l’invenzione di informazioni. Affidabilità: esiste questo divario tra capacità e affidabilità per cui è possibile dimostrare che un sistema di IA è in grado di fare qualcosa di davvero impressionante (capacità), ma se non lo fa effettivamente il 90, 95, 99% delle volte (affidabilità), potrebbe non essere poi così utile, a seconda dell’applicazione. Non abbiamo ancora visto nulla che si avvicini a un’affidabilità davvero elevata in alcuni dei compiti più sofisticati. Eccessiva sicurezza: un altro grande problema per questi modelli. Se fai una domanda, non hanno idea di quando dovrebbero dire «non lo so» o «lo so». Non sono molto bravi a riconoscere se hanno commesso un errore e a fare marcia indietro. Magari stanno migliorando, magari non rimarranno questioni intrattabili per sempre, ma si sono rivelate più difficili di quanto alcuni potessero aspettarsi.
-
Limiti fondamentali. Esistono anche limiti fondamentali nel modo in cui costruiamo i GPT al momento. Uno dei principali è che possono apprendere solo ciò che è contenuto nei dati di addestramento quando vengono addestrati in un unico grande blocco; è poi possibile inserire elementi nella loro finestra di contesto per ogni singolo caso d’uso, ma al momento non disponiamo di metodi efficaci per fare qualcosa a metà strada. Avere un sistema di IA che si utilizza per un determinato compito al lavoro, che lo esegue più volte e migliora col tempo, che ricorda che sei mesi fa hai avuto una conversazione che allora non sembrava rilevante ma ora lo è—può tornare indietro e consultare i propri appunti, o cose del genere. In realtà, non disponiamo di questo tipo di configurazione. Si stanno sperimentando soluzioni che consentono di costruire una base di conoscenza e far sì che l’IA la modifichi, e cose simili, ma non è una parte intrinseca del modo in cui costruiamo l’IA al momento, e per ora non funziona ancora bene. Allo stesso modo, la mancanza di un corpo fisico. La maggior parte dei sistemi di IA che utilizziamo attualmente non è integrata in sistemi fisici. Si stanno sicuramente registrando progressi interessanti nel campo della robotica, quindi, ripeto, forse la situazione cambierà, ma per ora penso che si tratti di un limite piuttosto significativo.
-
Rallentamento nello scalare il pre-addestramento. In effetti, per quanto riguarda i miglioramenti che otteniamo semplicemente scalando il pre-addestramento (quella fase iniziale di apprendimento per imitare il testo o altri tipi di dati), sembra piuttosto chiaro che il valore di continuare a scalare stia rallentando leggermente. Siamo anche a un punto in cui continuare a scalare significa spendere centinaia e centinaia di milioni di dollari. Quindi, se il valore non giustifica una spesa di centinaia e centinaia di milioni di dollari, potrebbe essere difficile continuare a salire lungo quella curva.
Il quadro è piuttosto incerto su entrambi i lati di questo bilancio; non è certo quanto siano valide le argomentazioni sul lato sinistro, né quanto lo siano quelle sul lato destro. Non voglio affermare che nessuno di essi sia solido al 100%. Ma penso che valga la pena prendere tutto sul serio, almeno in parte.
Penso che il modo in cui le persone interpretano questo grafico riassuma piuttosto bene il dibattito.
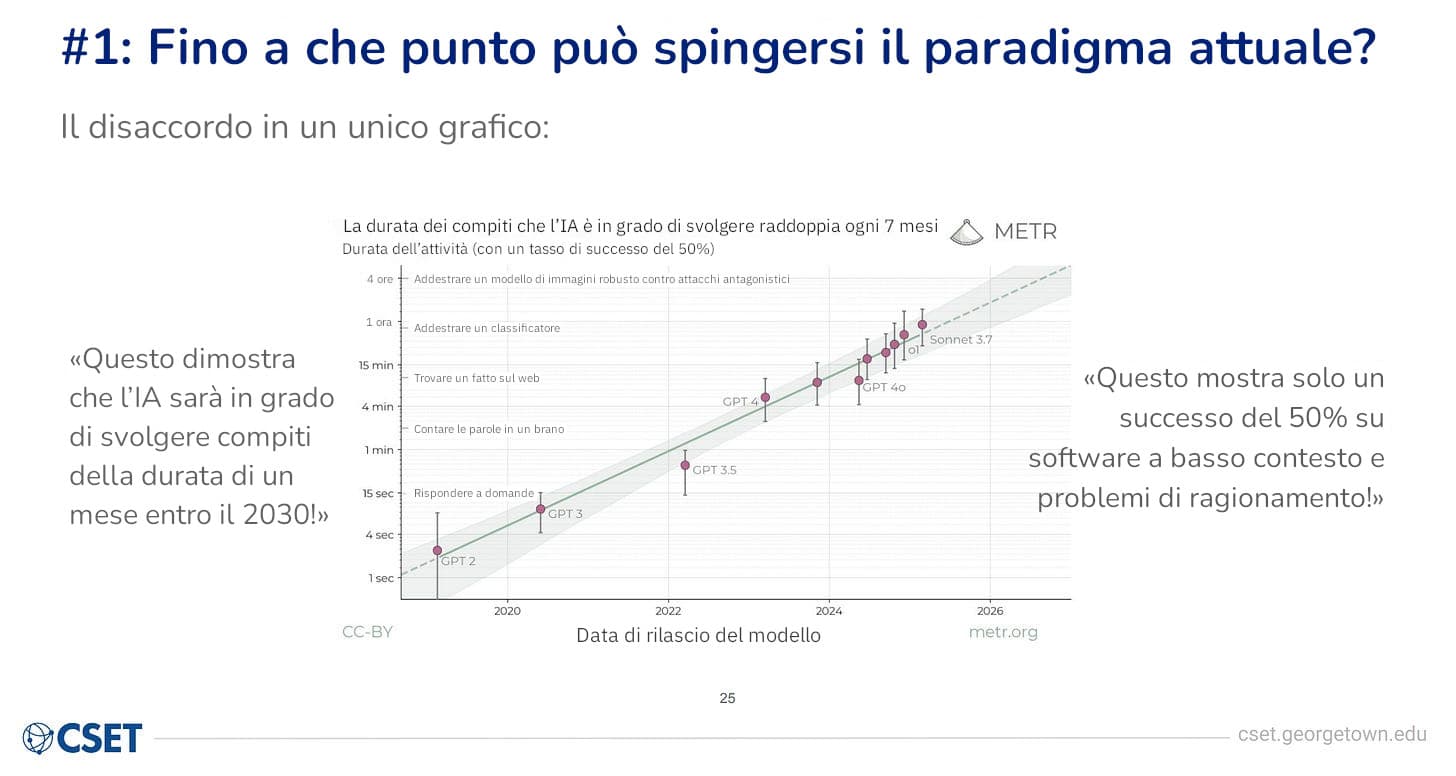
Per chi non l’avesse ancora visto, questo è un grafico di un’organizzazione chiamata METR, un eccellente ente di valutazione indipendente nel campo dell’IA. Hanno creato un dataset di compiti che richiedono tempi diversi per essere svolti dagli esseri umani. Hanno poi misurato l’efficacia con cui diversi sistemi di IA riescono a eseguire tali compiti e la durata di quelli che sono in grado di svolgere bene. L’idea di base è che se un sistema riesce a svolgere un compito che a un essere umano richiede un’ora, questo sarà più difficile rispetto a uno che richiede 20 secondi. Nel tempo si osserva questa curva in cui la durata dei compiti che i sistemi sono in grado di svolgere raddoppia ogni sette mesi. In realtà, di recente, credo che dati più aggiornati abbiano mostrato una curva ancora più ripida.
Alcuni osservano questo grafico e sostengono che dimostri come l’IA sia in grado di svolgere compiti sempre più lunghi. Se si estrapola la curva, si prefigura uno scenario in cui, entro il 2030, l’IA sarà in grado di svolgere compiti che richiedono un mese di tempo. Sarebbe molto complicato, o comunque molto più complicato di quanto l’IA sia in grado di fare al momento.
Altri osservano questo grafico e dicono: beh, ma guardate, il tasso di successo è del 50%. Quindi GPT-4 può svolgere un compito di circa cinque minuti, ma lo esegue correttamente solo nel 50% dei casi. All’atto pratico non è davvero utile, e se si traccia lo stesso grafico basandosi su un tasso di successo del 90% o del 99%, appare molto meno notevole. Inoltre, questi compiti sono avulsi dal contesto. Devono esserlo, per poter eseguire il test: devono essere dei piccoli frammenti isolati. E si tratta solo di problemi software e di ragionamento, non di un insieme più ampio. Quindi, una prospettiva diversa su questo grafico porterebbe a dire che in realtà non ci dice granché: mostra solo uno specifico tipo di progresso su uno specifico tipo di problema. E, ancora una volta, penso che ci sia del vero in entrambe le prospettive, e che solo il tempo ci dirà quale sia la risposta giusta.
#2: Quanto può l’IA migliorare l’IA?
Il secondo grande dibattito, che ritengo piuttosto centrale per molte altre divergenze, riguarda quanto l’IA sarà in grado di migliorare l’IA.
Questa idea originale è stata forse espressa per la prima volta in modo conciso da I.J. Good, uno dei primi informatici a lavorare con Turing. Scrisse questo interessante articolo sulle «macchine ultraintelligenti» — sto aspettando che quel termine torni in auge.
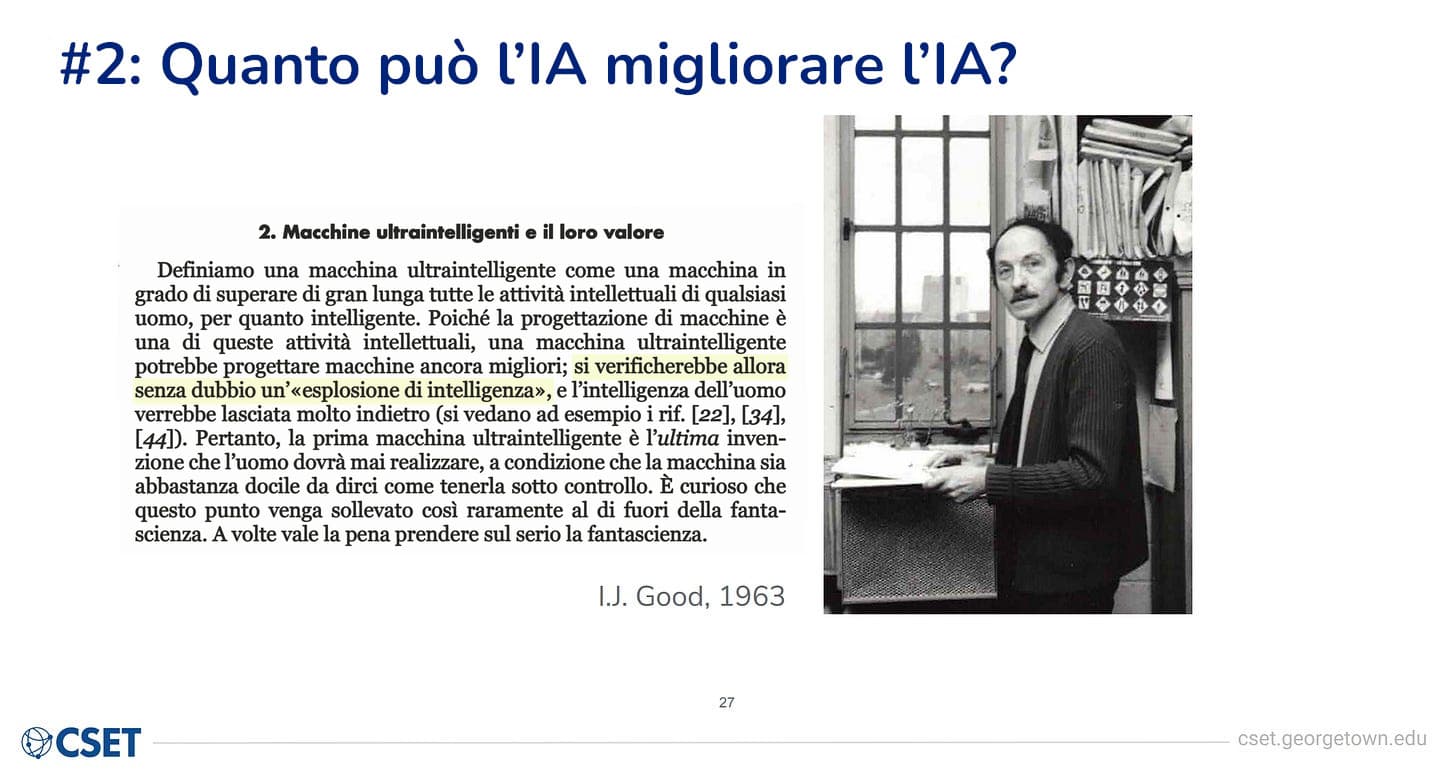
Good afferma che, se avessimo una macchina ultraintelligente che superasse le prestazioni umane in tutti i compiti, allora sarebbe di conseguenza più abile nel costruire altre macchine ultraintelligenti. Quindi «si verificherebbe allora senza dubbio un’esplosione di intelligenza, e l’intelligenza dell’uomo verrebbe lasciata molto indietro». Non dice nulla sull’intelligenza della donna, quindi siamo a posto. Sto scherzando.
Ma questa è l’idea di base. Se si può usare l’IA per migliorare l’IA, e l’IA diventa più brava degli esseri umani nel migliorare l’IA, allora si ottiene questa situazione di ciclo di retroazione con una curva a mazza da hockey.
E questo, in realtà, sta già cominciando ad accadere. Good ne parlava già circa 60 anni fa, ma solo negli ultimi anni stiamo iniziando a vedere segni davvero significativi di questo fenomeno.
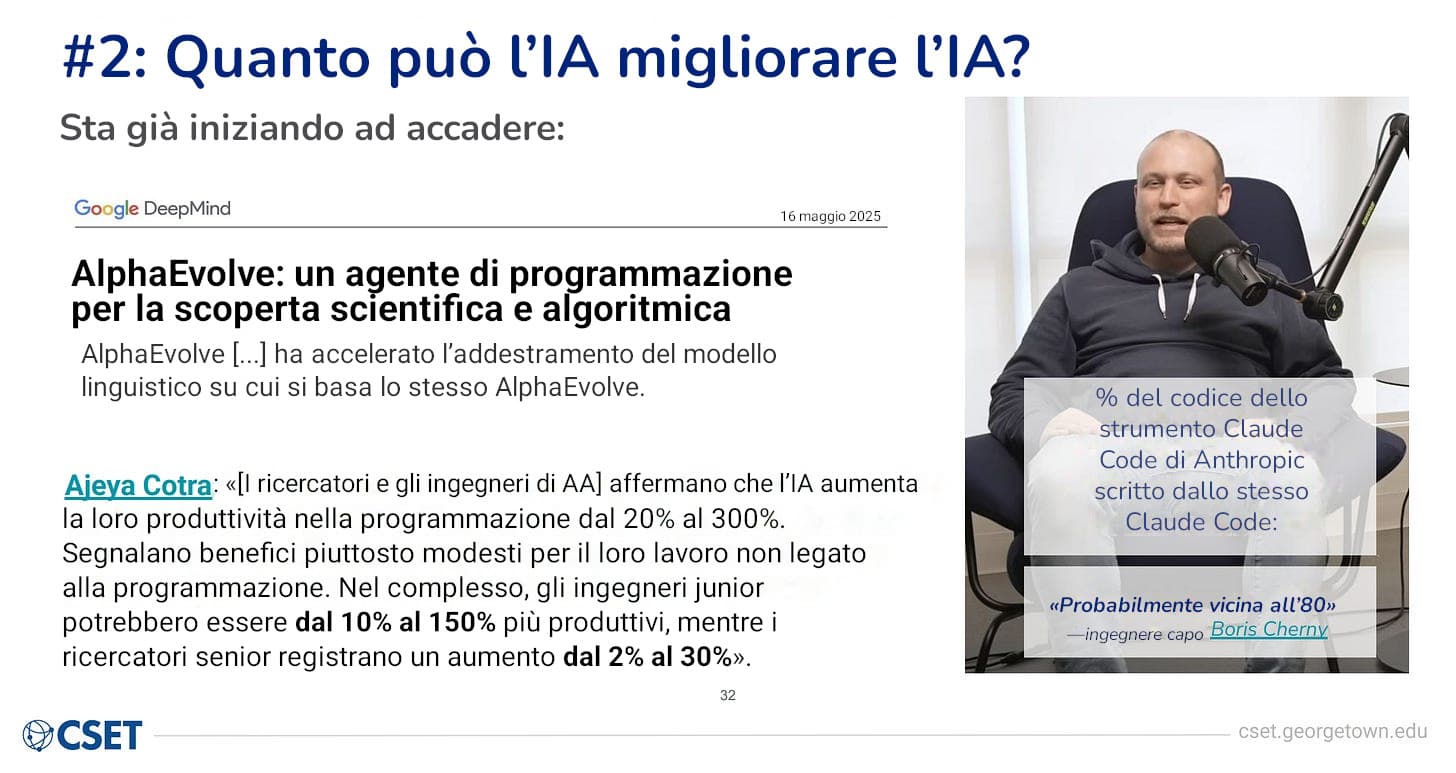
AlphaEvolve è un risultato di Google in cui utilizzano i loro modelli linguistici all’avanguardia come parte di un sistema volto a migliorare gli algoritmi: la scoperta evolutiva di algoritmi sempre migliori. Quel sistema è riuscito ad accelerare l’addestramento dei modelli linguistici presenti al suo interno, quindi in un certo senso migliorava se stesso. Credo abbiano affermato di aver accelerato l’addestramento di un modello Gemini dell’1%, e quando si parla di centinaia di milioni di dollari, l’1% inizia a rappresentare una somma considerevole.
Ci sono anche i primi risultati di una mia ex collega, Ajeya Cotra, che sta svolgendo un lavoro davvero eccellente in questo campo. Sta conducendo alcune indagini informali tra ricercatori e ingegneri di apprendimento automatico e, sulla base di numerose conversazioni, ha affermato che questi ultimi stavano già riscontrando quanto l’IA li aiutasse nel loro lavoro di ricerca e ingegneria. Le figure junior registravano un aumento della produttività compreso tra il 10 e il 150% grazie all’uso di strumenti di IA. Per i ricercatori senior l’aumento era un po’ più contenuto, ma comunque significativo: dal 2 al 30%.
Poi, proprio mentre mi preparavo per questo intervento, ho trovato questa statistica piuttosto interessante. Claude Code è uno strumento di Anthropic che aiuta gli sviluppatori a programmare (utilizzando Claude, da cui il nome). Questo è l’ingegnere capo di quel progetto, il quale ha affermato in un podcast che, per quanto riguarda il codice alla base dello stesso Claude Code, la percentuale scritta da Claude era «probabilmente vicina all’80[%]». Dunque una parte molto consistente di questo strumento di programmazione è stata scritta proprio dall’IA che lo alimenta.
Tuttavia, in realtà non sappiamo fino a che punto si spingerà tutto questo. Si pone quindi una questione: se l’IA è in grado di fare tutto ciò che sanno fare i ricercatori e gli ingegneri nel campo dell’IA, allora si crea naturalmente un ciclo di retroazione in cui tutto è limitato solo, ad esempio, dalla potenza di calcolo disponibile. Ma se si incontrano altri colli di bottiglia, o se ci sono altri fattori a rallentare il processo, allora potrebbe non verificarsi quel tipo di crescita ricorsiva a mazza da hockey.
Alcuni potenziali colli di bottiglia:
-
Errori che richiedono revisione umana: Al momento, il problema principale è che gli strumenti di programmazione (o di ricerca, o qualsiasi IA utilizzata per la ricerca sull’IA) commettono errori, ed è quindi necessario controllarli. Questo è un motivo importante per cui la produttività riportata da quei ricercatori nella diapositiva precedente non è ancora così elevata. Devono ancora esaminare tutto ciò che l’IA sta facendo, eseguire test, verificare che i test funzionino, ecc.
-
Intuito/giudizio nella ricerca: In futuro, forse ci saranno meno errori, ma se l’IA si limita a scrivere codice o a eseguire istruzioni piuttosto semplici, allora non possiede necessariamente quel tipo di intuito o giudizio nella ricerca di cui si ha bisogno per automatizzare davvero l’intero ciclo di ricerca e ingegneria.
-
Esperimenti e/o implementazioni nel mondo reale: E poi, anche se si potesse automatizzare tutto questo, forse ci sono esperimenti nel mondo reale che è necessario condurre, o implementazioni nel mondo reale — forse è necessario introdurla effettivamente in un’organizzazione o in un’azienda reale per vedere cosa funziona, cosa no, e ottenere quel feedback.
Quindi questi potrebbero essere tutti dei colli di bottiglia. Ma, d’altra parte, quanto siamo sicuri che tutti questi colli di bottiglia non possano essere automatizzati? Non ne sono sicura al 100%. Penso che sia una situazione in cui bisogna un po’ aspettare e vedere come andranno le cose. Il tempo ci dirà quali di questi sono davvero colli di bottiglia e quali invece possono effettivamente essere automatizzati.
#3: Le future IA saranno ancora fondamentalmente strumenti, o qualcos’altro?
Il terzo punto di disaccordo riguarda i futuri sistemi di IA e se avrà senso considerarli come strumenti.
L’articolo «AI As Normal Technology», che consiglio vivamente, è di Arvind Narayanan e Sayash Kapoor di Princeton, autori del blog AI Snake Oil. È un testo molto ricco, che formula in modo eccellente molte posizioni che, a mio avviso, tante persone condividono intuitivamente riguardo all’IA, ma che non hanno necessariamente espresso. Affermano: «Consideriamo l’IA uno strumento di cui possiamo e dobbiamo mantenere il controllo.»
Un altro famoso scettico riguardo al rischio legato all’IA, Yann LeCun, ha espresso una prospettiva simile: «I futuri sistemi di IA […] saranno sicuri e rimarranno sotto il nostro controllo perché *noi* ne stabiliamo gli obiettivi e i limiti di sicurezza e non potranno discostarsene.»
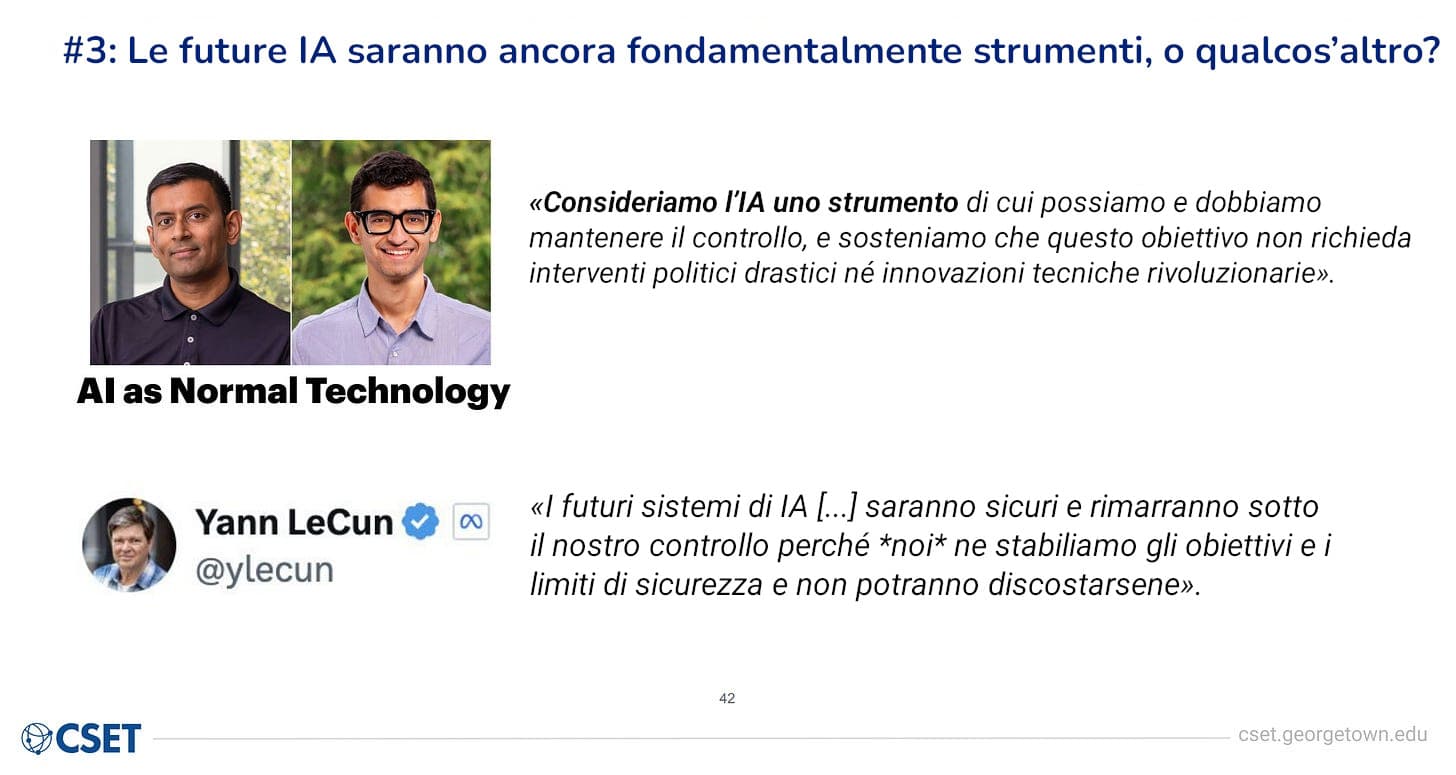
Penso sia davvero importante per chiunque non consideri l’IA in questo modo, o non consideri in questo modo i futuri sistemi di IA più avanzati, dedicare semplicemente un po’ di tempo a riflettere sul fatto che questo è davvero un punto di partenza molto ragionevole. È il modo in cui funzionano praticamente tutti i sistemi di IA oggi, è il modo in cui funziona la maggior parte delle tecnologie, ed è anche qualcosa con cui abbiamo già esperienza.1
Quindi, se sembra davvero che l’IA continuerà a essere uno strumento di cui siamo noi a determinare l’uso — apri l’app di ChatGPT, digiti una domanda, ti risponde, chiudi l’app e abbiamo finito — allora significa che le cose saranno molto più semplici sotto molti aspetti. Se questo è vero, allora non abbiamo davvero bisogno di passare troppo tempo a preoccuparci degli obiettivi del sistema di IA, o di quali valori possieda. È comunque un aspetto in qualche modo rilevante; se si pone una domanda su un tema politico, ci si preoccupa ancora del tipo di risposte che si ottengono, ma si tratta di una questione che riguarda meno la natura dell’IA in sé e più semplicemente i contenuti.
Allo stesso modo, se i sistemi di IA continueranno a essere strumenti, allora le persone avranno un ruolo davvero centrale. Il punto non è cosa vuole l’IA o cosa farà; il punto è chi utilizza l’IA e cosa ne farà. Forse ci preoccuperemo ancora di malfunzionamenti o guasti, ma la situazione sarà comunque molto più paragonabile alle tecnologie del passato.
Ma — penso che ci siano alcuni aspetti dell’IA che sono piuttosto diversi dalle tecnologie del passato.
Uno di questi è l’idea, che sentirete ripetere spesso dai ricercatori, secondo cui i sistemi di IA vengono cresciuti, non costruiti.
Ciò che intendono dire con questo è in contrasto, ad esempio, con uno smartphone: uno smartphone è costituito da piccoli componenti che assembliamo, e comprendiamo davvero a un livello molto dettagliato come funziona ciascuno di essi e come si incastrano tra loro per creare uno smartphone in grado di svolgere tutte le funzioni complesse che uno smartphone svolge.
Quando si tratta di IA, sistemi di apprendimento automatico, sistemi di apprendimento profondo, modelli linguistici di grandi dimensioni, non è affatto così che vengono sviluppati. Abbiamo invece questi algoritmi che applichiamo ai dati, utilizzando processi di ottimizzazione matematica che modificano tutti questi miliardi o btrilioni di numeri, e alla fine otteniamo qualcosa che sembra funzionare. Possiamo testarlo e vedere cosa fa, come sembra comportarsi, ma non abbiamo davvero quella comprensione componente per componente a cui siamo abituati con le tecnologie. Questo li rende un po’ più simili a un sistema organico — una pianta, un animale, persino un semplice batterio — piuttosto che a qualcosa che costruiamo noi stessi pezzo per pezzo.
C’è anche qualcosa di davvero insolito nei sistemi di IA che sta cominciando a emergere solo nell’ultimo anno o due, ovvero l’idea di consapevolezza situazionale. Non si tratta di coscienza né di alcun grande concetto filosofico; la consapevolezza situazionale è semplicemente: l’IA sembra in grado di tenere conto della situazione in cui essa stessa si trova?
Ciò che stiamo cominciando a osservare sono sistemi di IA che notano e commentano il fatto che una situazione di test in cui vengono inseriti, un qualche strano scenario ipotetico, sembra proprio un test. Quindi, se riescono a capire di trovarsi in una situazione di test e si comportano in modo diverso proprio perché pensano di essere testati, in un certo senso questo vanifica lo scopo del test stesso. Non siamo per niente abituati a tecnologie che si comportano in questo modo. Non è certo quello che farebbe il tuo smartphone se, ad esempio, stessi eseguendo un test per assicurarti che resista in acqua: non direbbe «Oh, mi stanno testando, quindi in acqua mi comporterò in modo diverso da come farei altrimenti». Questo non è affatto usuale quando pensiamo alle tecnologie intese come strumenti.2
Un ultimo punto, che riguarda il futuro, è che esistono incentivi finanziari/commerciali molto forti per costruire sistemi di IA che siano molto autonomi e molto generali. Sistemi a cui è possibile affidare compiti complessi, di ampio respiro, di alto livello e a lungo termine, per poi lasciarli liberi di svolgerli in modo autonomo senza troppe revisioni e senza troppi vincoli.
Potrebbe risultare che non sia fattibile costruire sistemi di IA che funzionino in questo modo. Oppure potremmo dimostrarci capaci di agire con determinazione e decidere di non voler realizzare sistemi di IA che funzionino così. Ma credo che il percorso predefinito che dovremmo aspettarci sia che vi siano incentivi davvero forti a farlo e che quindi, se è tecnicamente possibile e in assenza di un qualche intervento significativo, questi siano i tipi di sistemi che otterremo.
E se questo è corretto, e si dispone di sistemi molto autonomi e molto generali che operano in contesti complessi, allora non avrà davvero senso considerarli alla stregua di strumenti.
Una citazione che ho trovato utile a questo proposito è di Jack Clark, co-fondatore di Anthropic, dove dirige la politica. Si tratta di un estratto da un articolo più lungo sul suo Substack, ImportAI, che ho trovato molto profondo; ha scritto (enfasi aggiunta):
Dovremmo aspettarci che la volontà di indipendenza sia una conseguenza diretta dello sviluppo di sistemi di IA a cui viene richiesto di svolgere un’ampia gamma di compiti cognitivi complessi. […] Non stiamo creando stupidi strumenti: stiamo addestrando menti sintetiche. Queste menti sintetiche hanno un valore economico che cresce in proporzione alla loro intelligenza.
Ciò che mi piace di questa citazione è che non afferma che creeremo delle persone, che saranno coscienti o che proveranno sentimenti — forse alcune di queste cose sono vere, forse no, ma non è di questo che stiamo parlando. Ciò di cui parla Jack è semplicemente questo: il fatto di addestrare sistemi a svolgere compiti difficili e di valore economico in modi molto generici e aperti implica che potremmo veder emergere comportamenti apparentemente insoliti, che in realtà non sono tipici di uno strumento. Potremmo osservarli nei sistemi di IA e, ribadisco, stiamo già iniziando a intravederne i primi barlumi.
Penso che questi siano motivi per aspettarsi che, se la tecnologia continuerà a progredire, potrebbe smettere di sembrare uno strumento per apparire come qualcosa di leggermente diverso, forse più simile a quella che a volte viene definita una «seconda specie».
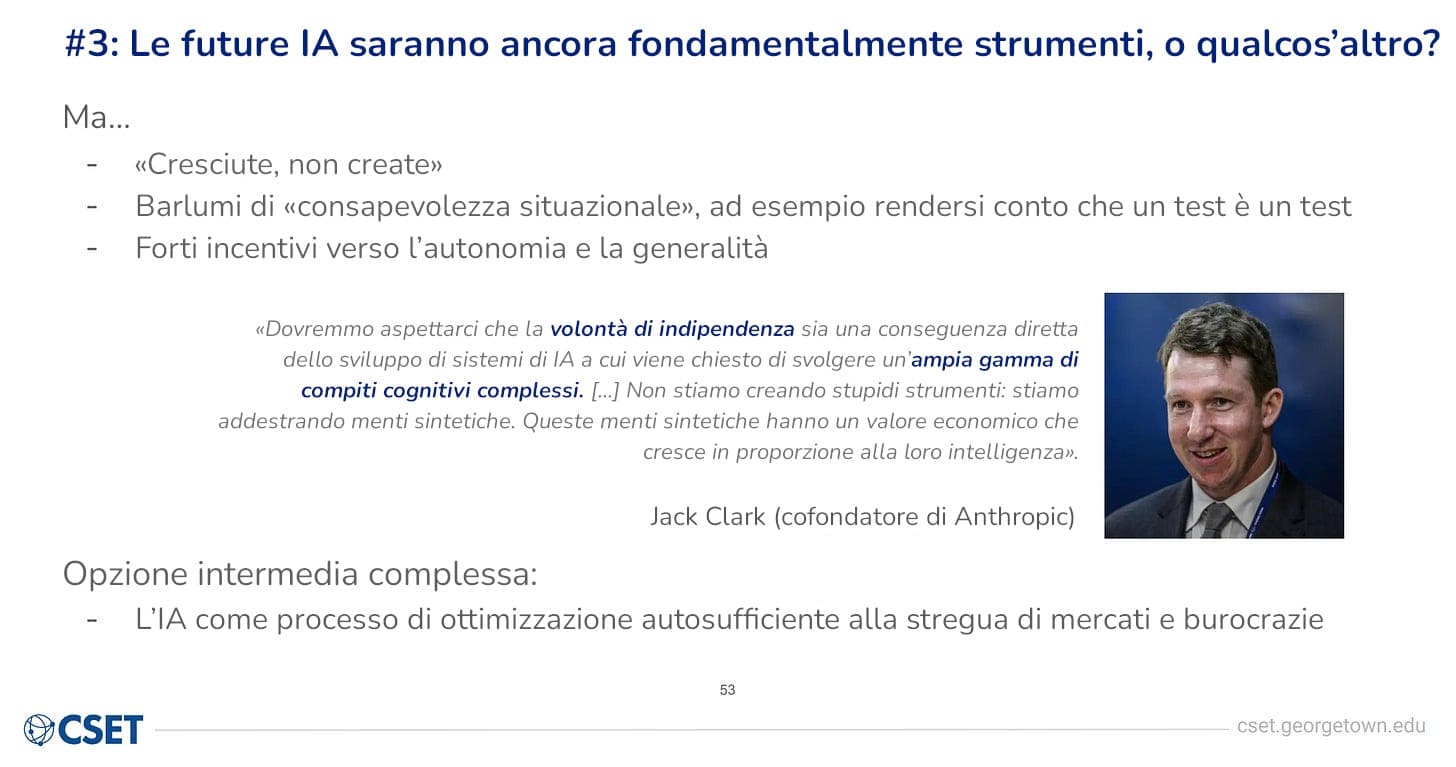
Un’ultima riflessione su questo terzo dibattito: se da una parte si sostiene che «sarà chiaramente solo uno strumento», dall’altra si afferma che «sarà qualcosa di simile a una seconda specie», una posizione intermedia che forse stiamo già iniziando a intravedere potrebbe essere quella di considerare l’intelligenza artificiale come un processo di ottimizzazione, magari un processo di ottimizzazione autosufficiente, del tipo che forse caratterizza un mercato o una burocrazia. Non è uno strumento, non è qualcosa che si prende, si usa e poi si ripone e smette di funzionare; non è nemmeno necessariamente un essere o una mente; ma è comunque molto potente e forse ha senso riflettere su cosa stia ottimizzando, quali obiettivi persegua, cosa potrebbe fare in futuro, anziché considerarla semplicemente uno strumento. Penso che questo sia anche un modo un po’ meno fantascientifico di concepire questo spettro di possibilità.
Conclusione
Per oggi mi fermo qui. Sembra che abbiamo tempo per un paio di domande. Spero che questi tre dibattiti siano un modo utile per scomporre alcune delle discussioni intrattabili e talvolta improduttive in questo ambito.