Cos’è l’allineamento dell’IA?
Questo articolo spiega i concetti chiave che emergono nel contesto dell’allineamento dell’IA.
Questi termini sono solo tentativi di accennare alle idee sottostanti, che sono ciò che conta veramente. Non esiste un consenso univoco su quale termine debba corrispondere a quale idea, e persone diverse usano i termini in modi diversi.1 Questo articolo spiega come utilizziamo queste parole nel nostro corso sull’allineamento dell’IA e in che modo la ricerca sull’allineamento contribuisca alla sicurezza dell’IA.
Far funzionare bene l’IA
L’IA avrà probabilmente un impatto senza precedenti sul mondo — forse paragonabile alla rivoluzione industriale o addirittura maggiore. I termini utilizzati per descrivere questi sistemi includono:
Intelligenza artificiale generale, o IAG: un termine notoriamente controverso che dà adito a infinite discussioni. Per evitarle, possiamo parlare di alcune proprietà, quali:
- prestazioni in compiti specifici; e
- generalità (ovvero quale gamma di compiti è in grado di svolgere l’IA).
Ad esempio, alcuni autori definiscono l’IA di livello umano come un’IA in grado di svolgere almeno il 95 % dei compiti economicamente rilevanti a un livello pari o superiore a quello umano.
IA trasformativa, o IAT: Un altro tentativo di aggirare i dibattiti sull’IAG consiste nel parlare invece dell’impatto dell’IA. L’IA radicalmente trasformativa, o spesso semplicemente IA trasformativa (IAT), si riferisce alle IA che portano a un aumento di 10 volte dell’innovazione rispetto all’era pre-IA.2
Ciò sarebbe analogo all’impatto della rivoluzione industriale, in cui la crescita media annua del PIL balzò dallo 0,2 % al 2 %. Un’altra rivoluzione di questo tipo porterebbe a una crescita annua del PIL del 20 %. (Sarebbe come passare da un mondo senza Internet diffuso a un mondo con gli smartphone nel giro di 2-3 anni, per poi assistere allo stesso livello di cambiamento nei 2-3 anni successivi, e così via.)
Per illustrare la differenza tra i termini IAT e IAG, si consideri uno scenario in cui la maggior parte dei lavori nell’economia sia svolta da sistemi di IA appositamente progettati. Ciò avrebbe probabilmente un impatto enorme e si qualificherebbe come IA trasformativa, indipendentemente dal fatto che i singoli sistemi siano o meno “generalmente intelligenti”.
Il nostro obiettivo finale è garantire che questi impatti significativi siano positivi, anziché negativi. La gamma dei potenziali impatti dell’IA è ampia:
Estinzione: Una preoccupazione espressa da molti esperti e personaggi pubblici è che l’IA possa letteralmente causare l’estinzione dell’umanità. Vedremo più avanti come ciò possa avvenire.
Catastrofe esistenziale: Correlata all’estinzione, una catastrofe esistenziale è un esito grave quanto l’estinzione umana. Questo potrebbe includere scenari in cui un regime totalitario oppressivo assume il controllo dell’umanità.
Rischi non esistenziali: I potenziali impatti negativi dell’IA non si limitano, ovviamente, alle catastrofi esistenziali. Includono anche problemi come l’esacerbazione dei pregiudizi da parte dell’IA, la disoccupazione o il contributo all’instabilità globale.
Crescita economica: La condizione umana è migliorata enormemente negli ultimi 200 anni, e il motore principale di questo progresso è stato, probabilmente, la crescita economica. Tuttavia, il progresso guidato dall’IA e l’automazione potrebbero rendere il mondo un luogo ancora migliore — forse in modo persino inimmaginabile.3
Sottoproblemi del «far funzionare bene l’IA»
Sebbene «far funzionare bene l’IA» sia il nostro obiettivo finale, esso ha lo svantaggio di essere troppo ampio e informale. Qui identifichiamo sottoproblemi più circoscritti e concreti: in particolare, questo corso si concentra principalmente sull’allineamento dell’IA:
Allineamento: far sì che i sistemi di IA cerchino di fare ciò che i loro creatori vogliono che facciano (alcuni lo chiamano allineamento delle intenzioni).
Esempi di disallineamento: i generatori di immagini creano immagini che esacerbano gli stereotipi o presentano una diversità irrealistica, i classificatori medici cercano righelli anziché caratteristiche clinicamente rilevanti e i chatbot dicono alle persone ciò che vogliono sentirsi dire piuttosto che la verità. In futuro, potremmo delegare più potere a sistemi estremamente potenti: se questi sistemi non facessero ciò che vogliamo che facciano, i risultati potrebbero essere catastrofici. Tra poco approfondiremo i sottoproblemi relativi all’allineamento.
Questo viene spesso contrapposto al problema delle capacità dell’IA:
Capacità: sviluppare sistemi di IA in grado di svolgere efficacemente i compiti che cercano di portare a termine.4
Esempi di fallimenti di competenza: sistemi di IA medica che forniscono raccomandazioni pericolose, oppure strumenti di stima dei prezzi immobiliari che causano perdite finanziarie significative. (Ma in entrambi questi casi i sistemi di IA cercano di fornire raccomandazioni accurate o di prevedere i prezzi con precisione).
Disporre di un solido allineamento e di solide capacità dell’IA è probabilmente necessario, ma non sufficiente per ottenere risultati benefici dall’IA. Altre componenti del problema includono:
Filosofia morale: determinare quali intenzioni sarebbe “bene” che i sistemi di IA avessero. Questo perché, se riusciamo a far sì che i sistemi di IA facciano ciò che intendiamo (allineamento), dobbiamo poi sapere cosa dovremmo volere che questi sistemi facciano. Ciò è difficile, dato che i dibattiti sul significato di “bene” proseguono da millenni e le persone hanno interessi diversi che a volte entrano in conflitto.
Governance: scoraggiare lo sviluppo o l’uso dannoso dei sistemi di IA. Esempi di fallimenti della governance: lo sviluppo sconsiderato o doloso di sistemi di IA pericolosi, oppure l’impiego di sistemi privi di misure di sicurezza contro un grave uso improprio. Se l’allineamento consiste nel disporre degli strumenti per guidare l’IA, e la filosofia morale ci indica dove dovremmo guidarla, la governance consiste nell’assicurarsi che le persone guidino effettivamente l’IA dove dovrebbero.
Resilienza: preparare altri sistemi a far fronte agli impatti negativi dell’IA. Ad esempio, se i sistemi di IA potenziano la capacità di alcuni attori di sferrare attacchi informatici, le misure di resilienza potrebbero includere il rafforzamento dei sistemi per prevenire gli attacchi informatici, l’aumento della capacità delle organizzazioni di funzionare durante un incidente informatico e l’accelerazione dei tempi di recupero da un attacco informatico.
Sebbene questa suddivisione costituisca un utile punto di partenza, non tutti i problemi possono essere chiaramente inquadrati in questo schema. Ad esempio, i jailbreak sono:
- un problema di allineamento (i creatori vogliono che i loro modelli seguano le istruzioni di sistema, ma ciò non avviene); e
- un problema di governance (gli attori non vengono dissuasi dall’uso improprio dei modelli di IA); e
- un problema di resilienza (i jailbreak potrebbero non costituire un problema se il danno che potrebbe essere causato fosse limitato).
Spesso è anche molto difficile distinguere i fallimenti di competenza da quelli di allineamento: può non essere chiaro di cosa siano effettivamente capaci i modelli di IA e se i fallimenti rappresentino:
- l’incapacità di svolgere correttamente i compiti (competenza); oppure
- il fatto che il modello sia in grado di svolgerli ma stia cercando di fare qualcos’altro (allineamento)
Ciò vale in particolare per i modelli linguistici di grandi dimensioni, dato l’enorme spazio dei possibili output — con tecniche come il prompting few-shot o chain of thought che sembrano «sbloccare» output migliori dallo stesso modello.
Infine, due avvertenze riguardo all’ambiguità del termine «sicurezza dell’IA». In primo luogo, mentre l’interpretazione intuitiva di questo termine è «prevenire gli incidenti con l’IA», molti ricercatori usano «sicurezza dell’IA» con la connotazione implicita di concentrarsi sull’IA radicalmente trasformativa. In secondo luogo, le etichette «sicurezza dell’IA» e «allineamento dell’IA» vengono talvolta applicate in modo improprio a causa del safety-washing, ovvero quando le organizzazioni cercano di far credere che stiano dando priorità alla sicurezza, mentre in realtà potrebbe non essere così.
Allineamento dell’IA
Far sì che i sistemi di IA cerchino di fare ciò che vogliamo è un compito sorprendentemente difficile. Questo problema viene comunemente suddiviso in allineamento esterno e interno.5 6
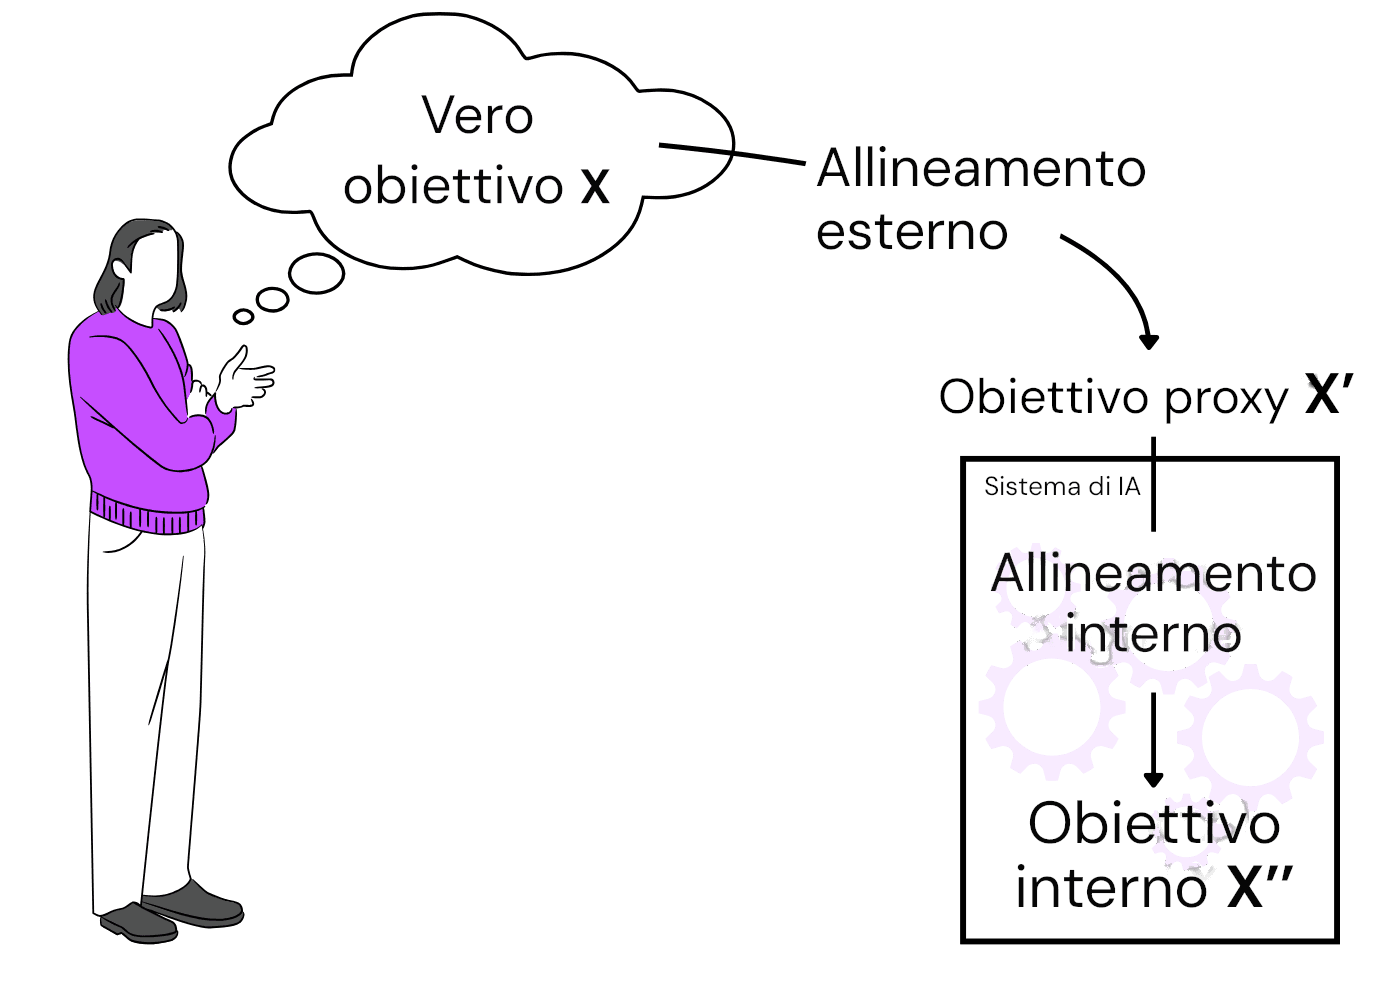
In questo modello, abbiamo un essere umano e un sistema di IA.
L’essere umano ha un vero obiettivo, X, che desidera raggiungere. Potrebbe trattarsi di qualcosa come «aumentare il valore della mia azienda».
Questo deve essere tradotto in qualcosa che un sistema di IA possa comprendere (ad esempio, in una funzione di perdita su cui eseguire la discesa del gradiente). Si crea quindi un obiettivo proxy, X’, da inserire nell’IA, che potrebbe essere «far salire il prezzo delle azioni».
Successivamente, addestriamo l’IA e ne otteniamo un’azione. L’IA sceglie un’azione in base a ciò che ha appreso. Le sue azioni potrebbero implicare un obiettivo interno diverso, X”, poiché potrebbe non aver appreso direttamente l’obiettivo proxy. Ad esempio, potrebbe imparare a cercare di ottimizzare affinché «vengano scritti articoli di giornale sull’aumento del prezzo delle azioni».
Se l’azione dell’IA non cerca di perseguire il vero obiettivo, chiamiamo questo fenomeno disallineamento — esterno o interno, a seconda che il problema si sia verificato al di fuori della scatola (un problema nella nostra specificazione dell’obiettivo) o all’interno della scatola (un problema legato a ciò che il modello ha imparato a fare in base alla specificazione dell’obiettivo).
- Esempio di disallineamento esterno: l’IA si rende conto di poter hackerare la borsa per far salire il prezzo delle azioni. Questo è un problema al di fuori della scatola, relativo alla nostra specificazione dell’obiettivo: l’IA ha tecnicamente raggiunto l’obiettivo che le avevamo fissato, ma non ha aumentato il valore dell’azienda, quindi X ≠ X’.
- Esempio di disallineamento interno: durante l’addestramento, l’IA viene ricompensata quando vengono scritti articoli di giornale positivi sul prezzo delle azioni. In fase di implementazione, è in grado di assumere un gruppo di giornalisti per scrivere articoli sul rialzo del prezzo delle azioni (raggiungendo il suo obiettivo interno X”), anche quando ciò non è avvenuto. Questo è un problema all’interno della scatola: i meccanismi interni non raggiungono l’obiettivo proxy X’ di far effettivamente salire il prezzo delle azioni, quindi X’ ≠ X”.
Esamineremo ora questi fallimenti più nel dettaglio e concluderemo commentando i limiti di questa impostazione.
1. Allineamento esterno: specificare correttamente gli obiettivi per un sistema di IA.
Noto anche come risoluzione di: errata specificazione della ricompensa, manipolazione della ricompensa, gioco delle specifiche, Goodharting.
Questo aspetto riguarda la sfida di specificare la funzione di ricompensa per un sistema di IA in modo che rifletta accuratamente le nostre intenzioni. Un’errata specificazione può spingere i sistemi di IA a ottimizzare in funzione di obiettivi che costituiscono solo un indicatore indiretto di ciò che vogliamo.
Esempio di disallineamento esterno: le aziende vogliono addestrare modelli linguistici di grandi dimensioni (MLGD) affinché rispondano alle domande in modo veritiero. Addestrano i sistemi di IA con una funzione di ricompensa basata su come le persone valutano le risposte. Gli esseri umani tendono a valutare molto positivamente ciò che sembra corretto, indipendentemente dal fatto che lo sia realmente. Questo incoraggia il sistema di IA a generare risposte apparentemente corrette ma di fatto false, ad esempio inserendo citazioni inventate.
Esempio di disallineamento esterno: le aziende di social media vogliono massimizzare i profitti pubblicitari. Potrebbero utilizzare sistemi di IA con l’obiettivo di massimizzare il coinvolgimento degli utenti, ma ciò spinge le loro piattaforme a promuovere clickbait, disinformazione o contenuti estremisti. Questo, a sua volta, riduce i profitti perché i clienti smettono di fare pubblicità sulla piattaforma.
2. Allineamento interno: far sì che l’IA segua questi obiettivi.
Noto anche come risoluzione di: errata generalizzazione degli obiettivi.
Quando addestriamo i sistemi di IA, forniamo loro un feedback (tramite la discesa del gradiente) in base alla nostra funzione di ricompensa. Questo porta a sistemi di IA che ottengono punteggi elevati nella funzione di ricompensa con i dati di addestramento.
Tuttavia, questo non significa che apprendano una politica che rifletta effettivamente la funzione di ricompensa che abbiamo impostato. Questo può causare problemi se gli ambienti di addestramento e di implementazione presentano distribuzioni di dati diverse (fenomeno noto come «spostamento di dominio» o «spostamento distributivo»).
L’allineamento tra l’obiettivo che il sistema di IA cerca di perseguire e l’obiettivo specificato è noto come «allineamento interno». Con «cerca di perseguire» intendiamo ciò che il sistema sembra ottimizzare, in base a come potrebbe scegliere tra diverse azioni.
Esempio di disallineamento interno: a un sistema di IA viene correttamente assegnata una ricompensa quando risolve dei labirinti. Durante l’addestramento, tutti i labirinti hanno un’uscita in basso a destra. Il sistema di IA apprende una politica che funziona bene: cercare sempre di dirigersi in basso a destra (anziché «cercare di dirigersi verso l’uscita»). In fase di implementazione, alcuni labirinti presentano uscite in posizioni diverse, ma il sistema di IA rimane semplicemente bloccato in basso a destra del labirinto.
Esempio di disallineamento interno (ipotetico): un’auto a guida autonoma viene addestrata utilizzando una ricompensa correttamente specificata, ovvero guidare senza incidenti. Durante l’addestramento apprende una strategia per guidare sempre senza passare col rosso, poiché questa funziona bene in tutti gli scenari di addestramento. Una volta in funzione, l’auto si trova ferma a un semaforo rosso. A un camion dietro di essa cedono i freni e l’autista suona il clacson. Sfortunatamente, i veicoli si scontrano poiché l’auto si rifiuta di spostarsi, dando la priorità al non passare col rosso rispetto all’evitare l’incidente.
Critiche alla distinzione tra allineamento interno ed esterno
A volte può essere difficile classificare i fallimenti come disallineamento esterno o interno. Ad esempio, i fallimenti possono essere ambigui o risultare da un disallineamento sia esterno sia interno, e alcuni ricercatori classificano i fallimenti in modo diverso a seconda di come vengono inquadrati.
Non è chiaro quanto la funzione di ricompensa sia direttamente pertinente al comportamento effettivamente appreso. Ciò mette in discussione la rilevanza dell’allineamento esterno, se sistemi come l’apprendimento per rinforzo potrebbero non ottimizzare direttamente questa ricompensa. Un programma di ricerca, la teoria degli shard, cerca di esplorare le relazioni tra le funzioni di ricompensa e i comportamenti appresi, e propone di impostare una funzione di ricompensa basata sui valori che essa insegna al modello, piuttosto che cercare di definire un obiettivo che corrisponda esattamente a ciò che desideriamo.
Infine, i futuri sistemi di IA potrebbero essere sviluppati senza funzioni di ricompensa specificate. I moderni MLGD hanno solitamente l’obiettivo di «generare testi coerenti che gli esseri umani valuterebbero positivamente». Tuttavia, i sistemi costruiti su di essi, come AutoGPT, cercano di renderli più autonomi e orientati agli obiettivi attraverso prompt ripetuti e il collegamento a strumenti, e non è chiaro come il paradigma dell’allineamento esterno/interno si applichi a questo contesto.
Nonostante queste critiche, riteniamo che conoscere questi concetti sia utile, dato che sono ampiamente utilizzati nel settore. Nel corso, li useremo per riflettere sulle sfide legate allo sviluppo di sistemi di IA allineati.
Definizioni alternative
Molti prima di noi hanno tentato di definire l’allineamento, e molti dopo di noi probabilmente ci proveranno. Altre definizioni comunemente utilizzate:
- Jan Leike: «Il sistema di IA svolge il compito previsto nel miglior modo possibile»
- Paul Christiano: «Quando dico che un’IA A è allineata con un operatore H, intendo: A sta cercando di fare ciò che H vuole che faccia.»
- Richard Ngo: «garantire che i sistemi di IA perseguano obiettivi in linea con i valori o gli interessi umani, anziché obiettivi involontari e indesiderabili»
- Ryan Greenblatt (in un contesto specifico): «Assicurati che i tuoi modelli non stiano tramando.»
- Nate Soares: «come, in linea di principio, orientare un potente sistema di IA verso un obiettivo specifico»
- Holden Karnofsky: «costruire sistemi molto potenti che non mirino a distruggere la civiltà»
- Anthropic: «costruire sistemi sicuri, affidabili e controllabili quando tali sistemi iniziano a diventare tanto intelligenti e consapevoli di ciò che li circonda quanto i loro progettisti»
- OpenAI: «rendere l’intelligenza artificiale generale (IAG) allineata ai valori umani e far sì che segua le intenzioni umane»
- Google DeepMind: «garantire che i sistemi di IA siano adeguatamente allineati ai valori umani»
- IBM: «codificare i valori e gli obiettivi umani nei modelli linguistici di grandi dimensioni per renderli il più utili, sicuri e affidabili possibile»