Un manuale per proteggere i pesi dei modelli di IA
Man mano che i modelli di intelligenza artificiale (IA) di frontiera — ovvero quei modelli che eguagliano o superano le capacità dei modelli più avanzati al momento del loro sviluppo — diventano più potenti, proteggerli dal furto e dall’uso improprio diventa sempre più cruciale. Di particolare importanza sono i pesi di un modello — i parametri apprendibili derivati dall’addestramento del modello su enormi dataset. Rubare i pesi di un modello consente agli aggressori di sfruttarlo per i propri scopi. La necessità di proteggere i modelli di IA ha anche importanti implicazioni per la sicurezza nazionale. Gli sviluppatori di IA e gli stakeholder dell’industria, del governo e della società civile hanno bisogno di un linguaggio comune per valutare le minacce, le posture di sicurezza e i risultati in materia di sicurezza.
I ricercatori della RAND hanno sviluppato una guida operativa, prima nel suo genere, per aiutare le aziende di IA a difendersi da un’ampia gamma di capacità degli aggressori, fino a includere gli attacchi più sofisticati: Securing AI Model Weights: Preventing Theft and Misuse of Frontier Models.1 Il rapporto mira inoltre a facilitare un dialogo costruttivo tra gli stakeholder sulle strategie di gestione dei rischi e sull’impatto più ampio della sicurezza dell’IA.
Questo documento di sintesi fornisce una panoramica del rapporto, che
- identifica 38 vettori di attacco sostanzialmente distinti
- esplora una gamma di potenziali profili di aggressori, dai criminali opportunisti agli Stati-nazione dotati di ingenti risorse
- stima la fattibilità di ciascun vettore di attacco per le diverse categorie di aggressori
- propone e definisce cinque livelli di sicurezza e raccomanda alcuni sistemi di sicurezza preliminari di riferimento che si avvicinano a tali livelli.
Per evitare lacune di sicurezza significative è necessario implementare integralmente un’ampia serie di pratiche di sicurezza. Tuttavia, diverse raccomandazioni dovrebbero rappresentare priorità urgenti per le organizzazioni di IA di frontiera:
- Sviluppare un piano di sicurezza basato su un modello di minaccia completo.
- Centralizzare tutte le copie dei pesi in sistemi monitorati e ad accesso controllato.
- Ridurre il numero di persone con accesso ai pesi.
- Rafforzare le interfacce per l’accesso al modello.
- Adottare una difesa in profondità per garantire la ridondanza.
- Implementare programmi contro le minacce interne.
- Adottare il «confidential computing» per proteggere i pesi e ridurre la superficie di attacco.
Sono necessarie alcune misure per proteggersi dagli aggressori più sofisticati. Tra queste figurano limitazioni fisiche della larghezza di banda tra i dispositivi o le reti contenenti i pesi e il mondo esterno; hardware per proteggere i pesi dei modelli fornendo al contempo un’interfaccia per l’inferenza; e reti sicure e completamente isolate per l’addestramento, la ricerca e altre interazioni. Poiché l’implementazione di tali iniziative può richiedere molto tempo (ad esempio, cinque anni), sarebbe opportuno che le organizzazioni iniziassero fin da ora.
Perché concentrarsi sulla sicurezza dei sistemi di IA, in particolare dei pesi dei modelli?
I modelli di IA avanzati promettono di aumentare la produttività del lavoro e migliorare la salute umana. Tuttavia, questa promessa comporta anche il rischio di un uso improprio e di conseguenze indesiderate legate alla loro implementazione.
La necessità di proteggere i modelli di IA di frontiera non è puramente commerciale: la preoccupazione che i rischi dei modelli di IA possano avere rilevanza per la sicurezza nazionale porta a includere nel calcolo dei rischi anche la sicurezza e gli interessi del pubblico.
Le potenziali minacce sono sofisticate, in particolare le operazioni ad alta priorità condotte dagli Stati-nazione. Le organizzazioni sviluppano le proprie strategie di sicurezza in base alla loro valutazione delle minacce. Tuttavia, la visione peculiare del team di sicurezza di una singola organizzazione potrebbe avere implicazioni che vanno oltre i confini dell’organizzazione stessa. Tutti gli stakeholder devono avere una comprensione condivisa di come le strategie di sicurezza, siano esse volontarie o governative, si traducano in sicurezza effettiva.
L’analisi del team di ricerca si è concentrata sui modi per prevenire il furto dei pesi dei modelli, ovvero i parametri apprendibili dei modelli di IA. I pesi di un modello di IA rappresentano il culmine di numerosi e costosi prerequisiti per l’addestramento di modelli di IA avanzati: ingenti investimenti in potenza di calcolo, grandi quantità di dati di addestramento e anni di ricerca da parte dei migliori talenti per ottimizzare gli algoritmi. Se gli aggressori entrano in possesso dei pesi di un modello, ottengono il controllo completo sul modello stesso.
Il team di ricerca ha analizzato una varietà di fonti scritte provenienti dalla letteratura accademica, da report commerciali sulla sicurezza, da documenti governativi ufficiali, da articoli dei media e da altre fonti online. Ha inoltre condotto interviste con quasi tre dozzine di esperti, tra cui funzionari governativi della sicurezza nazionale specializzati nella sicurezza delle informazioni, eminenti esperti del settore della sicurezza delle informazioni, personale senior addetto alla sicurezza delle informazioni presso aziende di IA di frontiera, altro personale senior di aziende di IA di frontiera, esperti indipendenti di IA con precedente esperienza in organizzazioni di IA di frontiera ed esperti di minacce interne.
Quali sono le potenziali vie di attacco?
Il team di ricerca ha identificato 38 vettori di attacco che potenziali aggressori potrebbero utilizzare per rubare i pesi dei modelli. I vettori non sono meramente teorici: la stragrande maggioranza è già stata utilizzata. La Tabella 1 descrive cinque vettori di attacco comuni e fornisce esempi del loro utilizzo. Gli esempi illustrano l’ampiezza delle capacità di attacco — da quelle estremamente comuni e semplici, come l’abbandono di chiavette USB nei parcheggi, agli attacchi più sofisticati, come lo sviluppo di strumenti di crittanalisi rivoluzionari che solo gli attori più capaci possono realizzare.
Questi esempi offrono un quadro intuitivo delle capacità dei diversi tipi di attori. Il rapporto completo fornisce descrizioni dettagliate degli attacchi e centinaia di esempi.
Tabella 1. Cinque vettori di attacco comuni
| Tipo di attacco | Approccio esemplificativo | Caso reale |
|---|---|---|
| Ingegneria sociale | Phishing: un aggressore può indurre un utente legittimo a eseguire codice dannoso o a condividere inavvertitamente le proprie credenziali di autenticazione, superando persino l’autenticazione a più fattori. | Si stima che il phishing sia responsabile di una perdita globale annua pari a 6,9 miliardi di dollari.2 Il phishing avanzato è offerto come servizio al costo di soli 400 dollari al mese.3 |
| Collocazione dolosa di dispositivi portatili | Collocazione di chiavette USB “abbandonate”: gli hacker possono “abbandonare” dispositivi USB nei parcheggi delle organizzazioni di loro interesse. Prima o poi, qualche dipendente inserisce la chiavetta USB nel proprio computer di lavoro per scoprire chi l’ha lasciata lì, consentendo all’hacker di eseguire codice all’interno della rete interna. È persino possibile acquistare cavi USB a 180 dollari che consentono il controllo remoto di un computer.4 | Diversi impianti nucleari statunitensi sono stati infettati con successo da malware tramite chiavette USB “abbandonate”.5 |
| Vettori di attacco specifici per l’IA | Le infrastrutture specifiche per l’IA tendono ad avere dipendenze estese e si evolvono più rapidamente rispetto alla maggior parte degli altri software, il che le rende ancora più vulnerabili agli attacchi alla catena di approvvigionamento. Gli aggressori possono introdurre intenzionalmente vulnerabilità nei pacchetti open source utilizzati dalle comuni infrastrutture di apprendimento automatico. | PyTorch, probabilmente il framework di sviluppo per l’apprendimento automatico più diffuso al mondo, è stato compromesso da un pacchetto software open source dannoso che aveva importato.6 |
| Accesso fisico non autorizzato ai sistemi | Aggressori particolarmente capaci possono non solo introdursi fisicamente nella sede in cui si trova un dispositivo, ma anche aggirare vari tipi di sicurezza hardware. Un approccio consiste nell’utilizzare il voltage glitching: variazioni della tensione fornita a un chip che ne causano il malfunzionamento e la divulgazione di informazioni che dovrebbero essere protette. | I chip di AMD, produttore di circa il 23 % di tutti i chip per desktop e server a livello globale, sono risultati vulnerabili a un attacco di “voltage glitching”.7 |
| Compromettere il sistema stesso di controllo degli accessi | Attori estremamente capaci possono individuare e sfruttare vulnerabilità negli elementi crittografici fondamentali alla base dei sistemi di crittografia, autenticazione e controllo degli accessi di uso comune. Lo sfruttamento di queste vulnerabilità minerebbe molte delle premesse su cui si basa la maggior parte dei sistemi di sicurezza. | Il metodo della “crittanalisi differenziale”, descritto da Eli Biham e Adi Shamir nel 1991,8 ha compromesso ampie porzioni dei sistemi di crittografia e autenticazione, in particolare la maggior parte di quelli che non erano stati specificamente ottimizzati per prevenirlo. In seguito è stato rivelato che IBM aveva scoperto questo tipo di attacco già nel 1974, per poi apprendere che la National Security Agency ne era a conoscenza da prima.9 |
Poiché i vettori di attacco sono così diversi e numerosi, le difese devono essere varie ed esaustive; garantire una solida sicurezza contro una specifica categoria di attacchi non protegge un’organizzazione dalle altre.
Inoltre, gli esempi di attacchi noti al pubblico rappresentano solo un sottoinsieme di quelli effettivi. Nelle interviste condotte dal team di ricerca, molti esperti di sicurezza nazionale hanno osservato che la stragrande maggioranza degli attacchi di cui sono a conoscenza, condotti da attori statali dotati di ingenti risorse, non è mai stata resa pubblica.
Quali sono le esigenze di sicurezza dei diversi sistemi di IA?
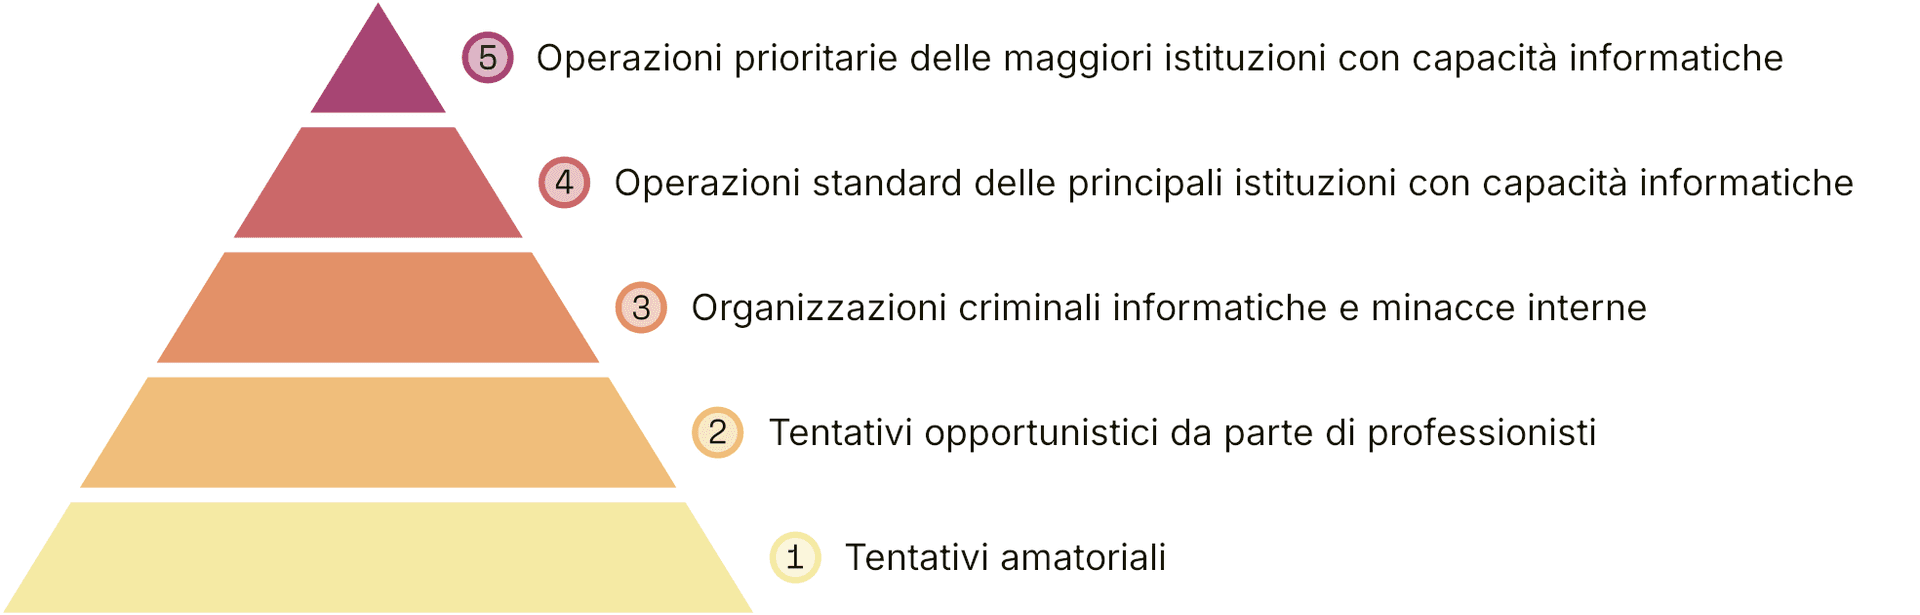
Per facilitare un dibattito più articolato sulle esigenze di sicurezza dei diversi sistemi di IA, Securing AI Model Weights: Preventing Theft and Misuse of Frontier Models propone cinque livelli di sicurezza (SL), definiti in linea di massima come il livello di sicurezza necessario per prevenire operazioni sempre più sofisticate:
- SL 1 è in grado di proteggere da tentativi amatoriali: hacker dilettanti e attacchi non mirati del tipo «spray and pray».
- SL 2 può probabilmente ostacolare i tentativi opportunistici dei professionisti: sia singoli hacker professionisti sia gruppi che eseguono attacchi non mirati o a bassa priorità.
- SL 3 fornisce protezione contro le organizzazioni criminali informatiche e le minacce interne. Tra queste figurano gruppi di hacker criminali di fama mondiale, organizzazioni terroristiche dotate di ingenti risorse e dipendenti scontenti.
- SL 4 può sventare le operazioni standard condotte dalle principali istituzioni dotate di capacità informatiche: ad esempio, molti dei principali gruppi sponsorizzati da Stati e agenzie di intelligence.
- SL 5 è in grado di sventare gli attacchi meno comuni ma più pericolosi: le operazioni di massima priorità condotte dagli Stati-nazione con le maggiori capacità al mondo.
In che modo le organizzazioni che si occupano di IA possono implementare misure di sicurezza proporzionali al rischio?
Attraverso una consultazione iterativa con esperti, il team ha definito un sistema di benchmark per ciascun SL. Il sistema offre uno strumento indicativo per calibrare la relazione tra l’implementazione delle misure di sicurezza e i risultati di sicurezza attesi. I benchmark suggeriscono misure e politiche concrete che si stima costituiscano i requisiti minimi di un sistema conforme agli obiettivi di quel livello di sicurezza. I benchmark non costituiscono né uno standard completo né un regime di conformità. Offrono alle organizzazioni suggerimenti concreti per i passi successivi.
Diversi laboratori di IA hanno stimato che, qualora lo sforzo fosse considerato prioritario, potrebbe essere necessario circa un anno per raggiungere lo SL 3; da due a tre anni per raggiungere lo SL 4; e almeno cinque anni, oltre al supporto della comunità di sicurezza nazionale, per raggiungere lo SL 5. Di seguito forniamo alcuni commenti selezionati, tratti dalla discussione sugli SL contenuta nel rapporto completo.
Tabella 2. Benchmark dei livelli di sicurezza
| Benchmark | Panoramica |
|---|---|
| SL 1 | A questo livello, le organizzazioni dovrebbero affidarsi ai prodotti di sicurezza esistenti e alle buone pratiche piuttosto che cercare di sviluppare soluzioni proprietarie. Lo SL 1 garantisce una protezione affidabile solo contro gli aggressori più banali. |
| SL 2 | La priorità assoluta a questo livello è un’implementazione completa e trasversale dei fondamenti, che non lasci irrisolto alcun “punto cieco”. È fondamentale dare priorità ai vettori di attacco più comuni: ad esempio, assicurarsi che la sicurezza delle e-mail, le politiche sulle password e l’autenticazione a più fattori siano applicate in modo corretto. |
| SL 3 | A questo livello, un obiettivo chiave è ridurre i rischi derivanti dalle minacce interne (ad esempio, i dipendenti dell’azienda), abbassando al contempo il rischio derivante da aggressori che si spacciano per personale interno o ottengono un accesso illegittimo ai dispositivi digitali dei dipendenti. La mitigazione di questi rischi comprende la riduzione del numero di persone autorizzate ad accedere ai pesi del modello, il rafforzamento delle interfacce a essi collegate e l’implementazione di una difesa in profondità. Il benchmark prevede il monitoraggio e la messa in sicurezza dell’intera catena di approvvigionamento: software, hardware e persino i condizionatori d’aria. |
| SL 4 | La restante superficie critica per la sicurezza può essere rafforzata, revisionata, monitorata e sottoposta a penetration test in modo esaustivo. Ciò richiede compromessi significativi in termini di produttività, praticità ed efficienza. Per proteggere i pesi durante l’uso è necessario implementare il confidential computing. Poiché gli attori statali dispongono di ampie capacità, il team di sicurezza deve possedere un’esperienza specifica nel fronteggiare tali attori. |
| SL 5 | Fatta eccezione per l’uso in produzione, i pesi sono conservati in un ambiente completamente isolato e disconnesso dal mondo esterno, con politiche estremamente rigorose sul trasferimento dei dati che impediscono anche a chi dispone di un accesso approvato di portare fuori dalla stanza grandi quantità di dati. Sono necessarie ulteriori attività di ricerca e sviluppo per consentire alle organizzazioni di supportare i modelli in produzione rispettando al contempo i requisiti di sicurezza dello SL 5. Attualmente non è possibile raggiungere lo SL 5. |
Misure di sicurezza raccomandate
Securing AI Model Weights: Preventing Theft and Misuse of Frontier Models descrive 167 misure di sicurezza raccomandate che costituiscono i benchmark di sicurezza. Questo documento fornisce due esempi — un piccolo campione delle numerose azioni importanti e fattibili che le organizzazioni possono intraprendere per proteggere i pesi dei propri modelli.
Rafforzamento delle interfacce per l’accesso ai pesi
In molti dei principali laboratori, centinaia o migliaia di persone hanno pieno accesso in «lettura» ai pesi dei modelli di frontiera. Ognuna di queste persone può effettuare una copia dei pesi, che potrebbe poi vendere o diffondere. Generalmente, queste persone hanno bisogno di usare i pesi per il proprio lavoro — ma la stragrande maggioranza non ha bisogno di poterli copiare. Questa misura di sicurezza raccomandata garantisce che gli utenti autorizzati interagiscano con i pesi tramite un’interfaccia software che riduce il rischio che questi vengano copiati in modo illegittimo.
La combinazione di tre semplici tipi di accesso potrebbe soddisfare le diverse esigenze operative dei dipendenti, riducendo al contempo in modo significativo il rischio di esfiltrazione:
- Utilizzo di codice predefinito revisionato e verificato dal team di sicurezza. Questa è la scelta più logica per le interfacce di inferenza (sia internamente sia per le interfacce di programmazione delle applicazioni [API] pubbliche).
- Accesso più flessibile (compresa l’esecuzione di codice personalizzato) su un server con output a velocità limitata, in modo che l’esfiltrazione di una porzione significativa dei pesi richieda troppo tempo per essere praticabile. Questa soluzione potrebbe essere utilizzata per la maggior parte dei casi d’uso legati alla ricerca e allo sviluppo.
- Lavoro diretto (senza vincoli sul codice o sulle velocità di output) su un computer isolato con air gap. Questo approccio può rivelarsi utile in rari casi in cui è necessaria una flessibilità completa, ad esempio quando si conducono ricerche sull’interpretabilità direttamente su modelli di frontiera.
Confidential computing
Anche se i pesi dei modelli (e altri dati sensibili) sono crittografati in transito e a riposo, essi vengono decrittografati e risultano vulnerabili al furto durante il loro utilizzo. Molti dipendenti, così come gli autori di attacchi informatici che dispongano anche solo di una minima presenza persistente, possono rubare i pesi una volta decrittografati in vista del loro utilizzo previsto. Il confidential computing è una tecnica che garantisce la sicurezza dei dati, anche durante l’uso, decrittografandoli esclusivamente all’interno di un ambiente di esecuzione affidabile (TEE) basato su hardware, il quale non esegue codice non sicuro. L’implementazione del confidential computing per proteggere i pesi dei modelli di IA potrebbe ridurre significativamente la probabilità che tali pesi vengano rubati.
Tuttavia, il confidential computing deve essere implementato correttamente:
- Il TEE deve includere protezioni contro gli attacchi fisici (le attuali implementazioni del confidential computing nelle unità di elaborazione grafica [GPU] non le prevedono).
- I pesi del modello devono essere crittografati con una chiave generata all’interno del TEE e conservata al suo interno.
- Il TEE eseguirà solo codice firmato, prestabilito e sottoposto a revisione. Tale codice decrittografa i pesi, esegue l’inferenza e restituisce in output solo la risposta del modello. Il codice non può fornire in output i pesi, la chiave di crittografia dei pesi né alcuna informazione prodotta direttamente dal modello.
L’uso del confidential computing nelle GPU è ancora agli albori e potrebbe non essere pronto per la produzione nei sistemi di frontiera. Tuttavia, esiste un vastissimo consenso tra gli esperti riguardo alla sua importanza e se ne prevede l’implementazione a breve.
In che modo Securing AI Model Weights: Preventing Theft and Misuse of Frontier Models può essere utilizzato dagli stakeholder?
È in corso un dibattito acceso sulla misura in cui i diversi modelli debbano essere protetti (ammesso che lo debbano essere). L’obiettivo del team di ricerca era migliorare la capacità di proteggere qualsiasi modello di IA di frontiera ritenuto meritevole di protezione al livello di sicurezza (SL) desiderato, sistematizzando le conoscenze su quali posture di sicurezza consentano di raggiungere i vari risultati di sicurezza auspicabili, in particolare nel contesto della protezione dei sistemi di IA e dei pesi dei loro modelli. Securing AI Model Weights: Preventing Theft and Misuse of Frontier Models supporta un processo decisionale informato sia nel settore privato che in quello pubblico:
- I dirigenti e i team di sicurezza delle principali aziende di IA possono esaminare i vettori di attacco descritti nel rapporto e i numerosi casi documentati del loro utilizzo. Molti esperti di sicurezza intervistati dal team di ricerca conoscevano alcuni vettori di attacco, ma ne ignoravano altri o si mostravano scettici al riguardo. Questa lacuna conoscitiva può rendere vulnerabili i loro sistemi.
- Le aziende di IA dovrebbero inoltre confrontare la loro attuale postura di sicurezza con i cinque benchmark di sicurezza. Individuando il benchmark più vicino al loro stato attuale, possono comprendere meglio da quali attori siano verosimilmente protette e, cosa ancor più importante, quali continuino a rappresentare una minaccia. I benchmark non sono prescrittivi e i loro dettagli evolveranno nel tempo, ma costituiscono un utile strumento di calibrazione.
- Le aziende possono utilizzare i benchmark di sicurezza per individuare i passi successivi volti a migliorare la propria postura di sicurezza. Se alle aziende mancano misure di sicurezza specifiche (o alternative più adatte alla loro infrastruttura) per soddisfare un determinato benchmark, dovrebbero concentrarsi innanzitutto su di esse. Una volta raggiunto un benchmark di sicurezza, possono guardare a quello successivo per ulteriori raccomandazioni e definire i prossimi passi.
- I benchmark di sicurezza potrebbero anche costituire il fondamento di standard e normative, fornendo alle autorità di regolamentazione e ai dirigenti una solida base di concetti e misure per valutare quale livello di sicurezza le aziende abbiano raggiunto o intendano raggiungere.